


В соответствии с 98-ФЗ незаконное получение, использование или разглашение сведений, составляющих коммерческую тайну, может повлечь штраф до 5 млн рублей и лишение свободы на срок до 7 лет. Несоблюдение требований конфиденциальности и безопасности данных корпоративных документов, содержащих персональную информацию, по 152-ФЗ может привести к штрафам до 20 млн рублей, а при повторных нарушениях — оборотные штрафы до 500 млн рублей. При трансграничной передаче санкции включают лишение свободы на срок до 10 лет. Привлечение подрядчика к обработке не освобождает оператора от ответственности.

Как работает распознавание для ИИ‑агентов
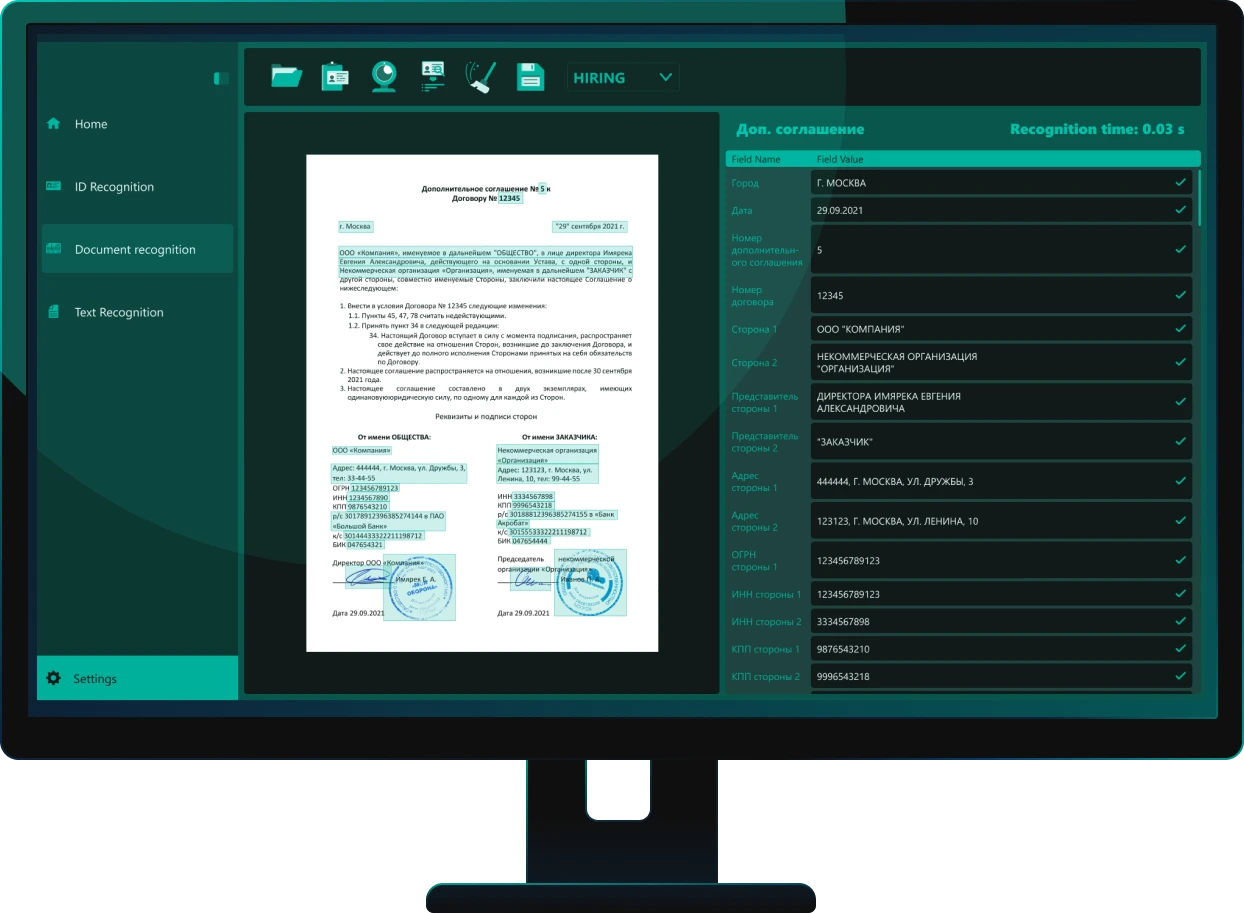
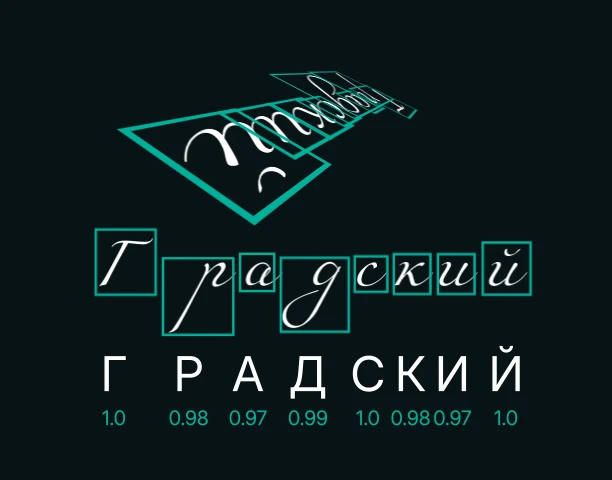
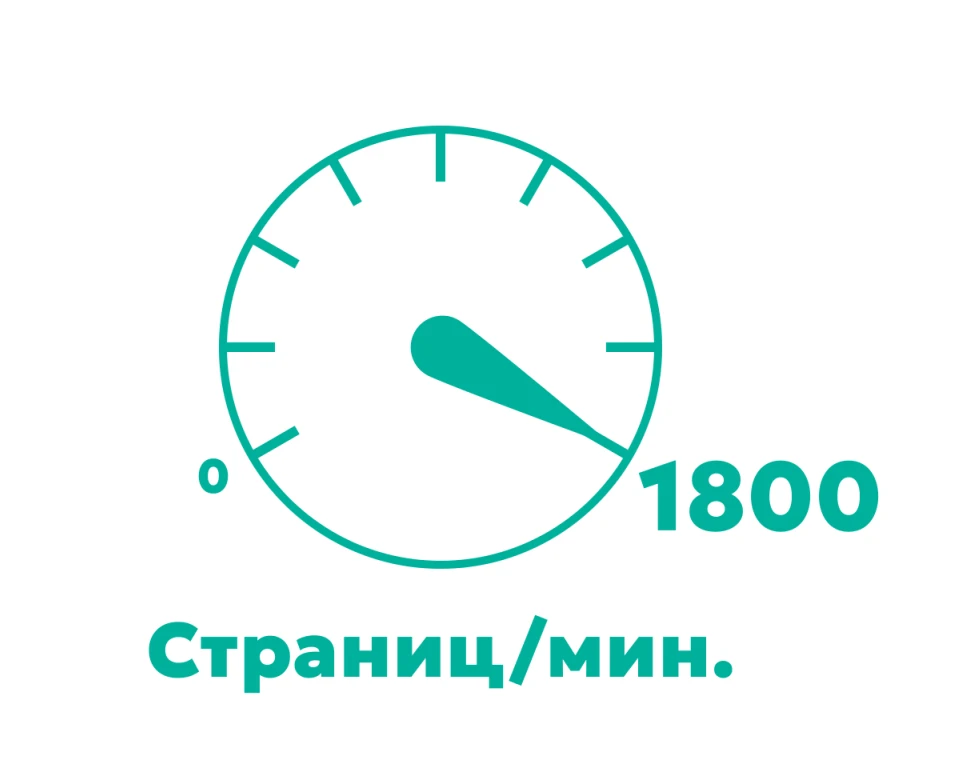
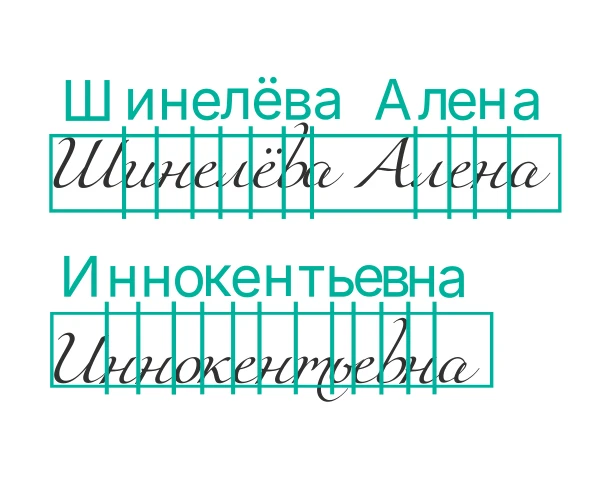
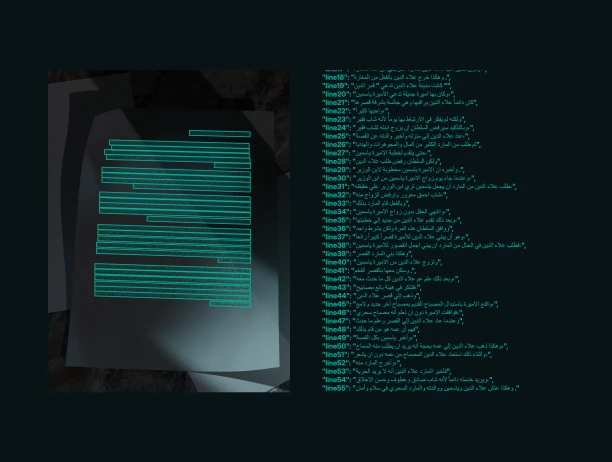
Надежное и точное распознавание текстов для создания ИИ-агентов на базе LLM‑моделей, где критически важна полнота, скорость и особенно достоверность данных. Система распознает печатный текст на 100+ языках, включая арабский, китайский, японский и корейский, кириллический, рукописный и смешанный тексты. Для результатов распознавания возвращает знакоместа, альтернативы и всю геометрию. ПО работает с фото и сканами низкого качества. Поддерживается поиск, выравнивание и нормализация документа, распознавание таблиц и многостраничных файлов, классификация документов и выделение реквизитов. Решение работает автономно в контуре заказчика, не требует GPU, обрабатывает до 1800 страниц в минуту на сервере.

Учредители — резиденты РФ

Собственная разработка

Запись 9617 в реестре ПО

Поддержка российских ОС
Возможности распознавания
- Распознавание сканов и фотографий низкого качества
- Поиск, выравнивание и нормализация документа на фотографии
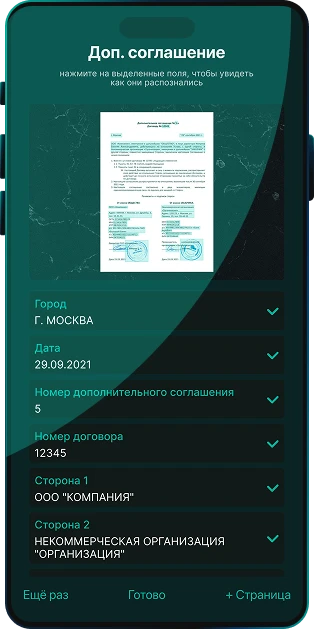
- Распознавание документа А4 на смартфоне за 2-3 секунды
- GreenOCR® — экологичный искусственный интеллект распознавания текста
- Уникальные 4.6-битные нейросетевые модели для скоростного распознавания на CPU
- Распознавание силами CPU, не требует ресурсов GPU и NPU
- Высокоточное распознавание текста на фото и скане
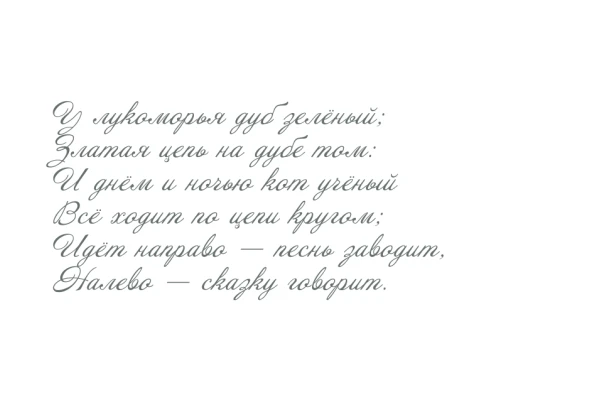
- Распознавание рукописных текстов, надписей и пометок вне зависимости от почерка
- Новаторские малобитные и компактные нейросетевые модели
- Распознавание печатной и рукописной кириллической письменности
- Высокоточный OCR для всех языков, базирующихся на латинице
- Распознавание арабского, японского, корейского и китайского языков
- Распознавание иврита, греческого, грузинского и армянского
- Распознавание многостраничных документов
- Поиск и распознавание таблиц
- Потоковое распознавание в контуре (on-premise) со скоростью более 100 тысяч страниц в час на сервере без GPU
- Надежное распознавание рукописи и печатного текста без лингвистических галлюцинаций
- AI модели обучены исключительно на синтетических данных
- Возврат геометрии текстов и символов
- Возврат альтернатив распознавания каждого символа
- Автоматическое определение типа документа
Какие документы
распознаются
- ЕГРИП
- ЕГРЮЛ
- ИНН юр.лица
- Приказ о назначении генерального директора
- Устав компании
- Отчет о финансовых результатах
- Свидетельство ОГРН
- Свидетельство ОГРНИП
- ЕГРН
- Паспорт РФ (печатный и рукописный)
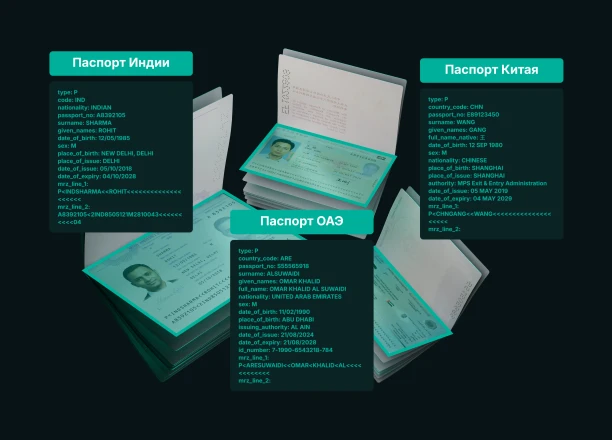
- Документы, удостоверяющие личность, 230+ стран и юрисдикций мира (паспорта, ID-карты, водительские удостоверения и др.)
- 2-НДФЛ
- Акт
- Акт КС-2
- Акт МХ-1
- Акт МХ-3
- Акт ОС-1
- Акт ОС-15
- Акт ОС-1а
- Акт ОС-4
- Акт передачи прав (шаблон 1С)
- Акт сверки
- Банковский ордер
- Бух. баланс
- Инкассовое поручение
- Книга покупок
- Корректировочный счет-фактура
- Платежное поручение
- Платежное требование
- Платежный ордер
- Реестр сертификатов и деклараций (приложение к накладной)
- Сертификат самозанятого
- Справка КС-3
- Справка о доходах по налогу на профессиональный доход
- Справка-расчет рублевых сумм документа в валюте
- Счет
- Счет-фактура (включая исправленный счет-фактуру)
- Товарно-транспортная накладная (ТТН)
- ТОРГ-12
- ТОРГ-13
- УКД
- Универсальный передаточный документ (УПД)
Возможности
интеграции
DocEngine engine = DocEngine.Create(<PATH_TO_CONFIGURATION_FILE>, true);
DocSessionSettings settings = engine.CreateSessionSettings();
settings.SetCurrentMode("primary_accounting");
settings.AddEnabledDocumentTypes("*");

DocSession session = engine.SpawnSession(settings, <PERSONALIZED_SIGNATURE>);
DocProcessingSettings proc_settings = session.CreateProcessingSettings();
Image image = Image.FromFile(<PATH_TO_IMAGE>);
session.ProcessImage(image, proc_settings);

DocResult result = session.GetCurrentResult();
Document doc = result.DocumentsBegin().GetDocument();
for (DocTextFieldsIterator iterator = doc.TextFieldsBegin(); !iterator.Equals(doc.TextFieldsEnd()); iterator.Advance()) {
  String name = iterator.GetField().GetBaseFieldInfo().GetName();
  String value = iterator.GetField().GetOcrString().GetFirstString().GetCStr();
}
std::unique_ptr<se::doc::DocEngine> engine(se::doc::DocEngine::Create(<PATH_TO_CONFIGURATION_FILE>, true));
std::unique_ptr<se::doc::DocSessionSettings> settings(engine->CreateSessionSettings());
settings->SetCurrentMode("primary_accounting");
settings->AddEnabledDocumentTypes("*");
std::unique_ptr<se::doc::DocSession> session(engine->SpawnSession(*settings, <PERSONALIZED_SIGNATURE>));
std::unique_ptr<se::doc::DocProcessingSettings> proc_settings(session->CreateProcessingSettings());
std::unique_ptr<se::common::Image> image(se::common::Image::FromFile(<PATH_TO_IMAGE>));
session->ProcessImage(*image, proc_settings.get());

const se::doc::DocResult& result = session->GetCurrentResult();
const se::doc::Document& doc = result.DocumentsBegin().GetDocument();
for (auto iterator = doc.TextFieldsBegin(); iterator != doc.TextFieldsEnd(); ++iterator) {
  std::string name = iterator.GetFieldPtr()->GetBaseFieldInfo().GetName();
  std::string value = iterator.GetFieldPtr()->GetOcrString().GetFirstString().GetCStr();
}
DocEngine engine = DocEngine.Create(<PATH_TO_CONFIGURATION_FILE>, true);
DocSessionSettings settings = engine.CreateSessionSettings();
settings.SetCurrentMode("primary_accounting");
settings.AddEnabledDocumentTypes("*");
DocSession session = engine.SpawnSession(settings, <PERSONALIZED_SIGNATURE>);
DocProcessingSettings proc_settings = session.CreateProcessingSettings();
Image image = Image.FromFile(<PATH_TO_IMAGE>);
session.ProcessImage(image, proc_settings);

DocResult result = session.GetCurrentResult();
Document doc = result.DocumentsBegin().GetDocument();
for (DocTextFieldsIterator iterator = doc.TextFieldsBegin(); !iterator.Equals(doc.TextFieldsEnd()); iterator.Advance()) {
  String name = iterator.GetField().GetBaseFieldInfo().GetName();
  String value = iterator.GetField().GetOcrString().GetFirstString().GetCStr();
}
engine = pydocengine.DocEngine.Create(<PATH_TO_CONFIGURATION_FILE>, True)
settings = engine.CreateSessionSettings()
settings.SetCurrentMode("primary_accounting")
settings.AddEnabledDocumentTypes("*")
session = engine.SpawnSession(settings, <PERSONALIZED_SIGNATURE>)
proc_settings = session.CreateProcessingSettings()
image = pydocengine.Image.FromFile(<PATH_TO_IMAGE>)
session.ProcessImage(image, proc_settings)

result = session.GetCurrentResult()
doc = result.DocumentsBegin().GetDocument()
iterator = doc.TextFieldsBegin()
while iterator != doc.TextFieldsEnd():
  name = iterator.GetField().GetBaseFieldInfo().GetName()
  value = iterator.GetField().GetOcrString().GetFirstString().GetCStr()
  iterator.Advance()
Уверенность распознавания, координаты объектов, вырезание полей и документов
Возврат зоны принятия решения для проверок подлинности
Операционные системы
- Android
- iOS
- MS Windows
- Linux
- ОС Аврора
- ОС Эльбрус
- РЕД ОС
- Astra Linux
- ОС Атликс
- ОС Альт Линукс
Low-code интеграция, простой и понятный REST API
- API на
- C
- C++
- C#
- Java
- Python
- PHP
- Фреймворки:
- React Native
- Flutter
- интеграция с 1C
- Примеры использования на языках
- C
- C++
- C#
- Java
- Python
- PHP
Архитектуры процессоров
- х86
- x86_64
- ARMv7-v8-v9 (AArch32 и AArch64)
- MIPS (MIPS32 и MIPS64)
- Elbrus
Распознавание текста, оптимизированное для построения ИИ‑агентов на основе LLM
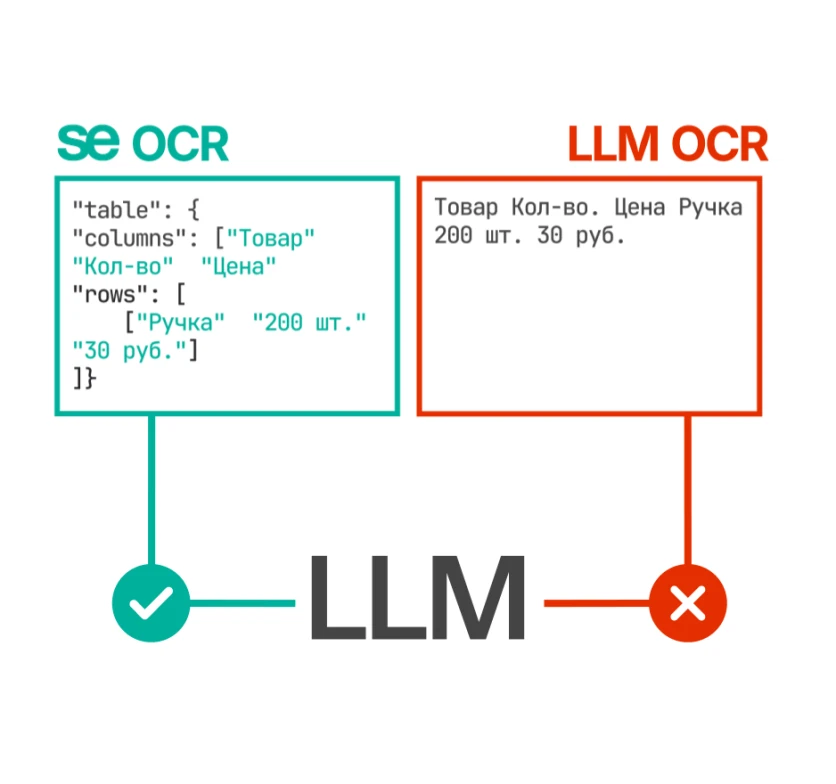
Система Smart Engines формирует высокоточный текстовый вывод, оптимизированный для обработки большими языковыми моделями (LLM). Технология возвращает весь оцифрованный текст без искажений и потери исходной структуры, что позволяет значительно повысить качество данных для ИИ-агентов и упростить интеграцию с AI-системами.
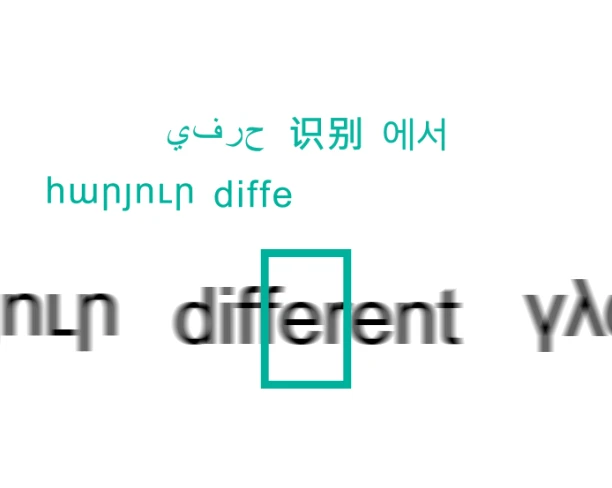
Распознавание текста документов на 100+ языках, включая арабский, китайский, японский и корейский
Технология Smart Engines обеспечивает омнифонтовое распознавание текста более чем на 100 языках мира независимо от гарнитуры, начертания и качества печати. Система одинаково эффективно работает с латиницей, кириллицей, арабской вязью, китайскими и японскими иероглифами, корейским письмом и другими сложными системами письменности.
State-of-the-art методы поиска текстов на изображениях документов
Система Smart Engines использует наиболее передовые нейросетевые алгоритмы для поиска и локализации текста на изображениях документов любой сложности. Искусственный интеллект с высочайшей точностью определяет текстовые области и извлекает данные даже на низкокачественных сканах и фотографиях, включая изображения с артефактами сканирования, шумами, перекосами, тенями и сложным фоном.
Классификация и выделение реквизитов из 80+ видов деловых документов РФ и 3000+ типов ДУЛ всего мира
Система автоматически определяет тип документа на фото и сканах и извлекает ключевые реквизиты из деловых документов РФ и документов, удостоверений личности всего мира. Технология Smart Engines поддерживает потоковую обработку больших массивов документов, ускоряя ввод данных, проверку и автоматизацию бизнес-процессов.
Распознавание печатных, рукописных и смешанных текстов с возвратом всех альтернатив для NLP методов
Искусственный интеллект извлекает любой печатный, рукописный и смешанный текст, включая трудноразборчивый почерк и пометки, сделанные от руки. Для последующей обработки NLP-моделями система возвращает знакоместа, альтернативы и всю геометрию, позволяя строить высокоточные сценарии анализа, обработки и принятия решений с помощью ИИ-агентов.
Скорость распознавания 1800 страниц в минуту на сервере без применения GPU
Система Smart Engines обеспечивает сверхбыструю обработку документов — до 1800 страниц в минуту на одном сервере без использования GPU. Архитектура решения позволяет масштабировать технологию под любые объемы нагрузки без усложнения существующей ИТ-инфраструктуры, обеспечивая максимальную производительность и минимальные затраты на вычислительные ресурсы.
Распознавание без обработки — возвращает то, что на бумаге
Система извлекает весь текст и реквизиты из документов в исходном виде «as is» — без интерпретации и вмешательства в исходные данные. В отличие от LLM, склонных к галлюцинациям, искусственный интеллект Smart Engines обеспечивает точное и проверяемое распознавание, необходимое для юридически значимых и бизнес-критичных процессов.
Распознает сканы и фотографии в реальных условиях и низкого качества
Технология Smart Engines с высочайшей точностью распознает документы, снятые в условиях реальной жизни: при плохом освещении, сложном фоне, размытии, перекосах, бликах и низком разрешении. Алгоритмы искусственного интеллекта устойчивы к артефактам на фотографиях и сканах, обеспечивая нормализацию и точное извлечение данных даже в случаях, где не справляются традиционные OCR-инструменты.
Работает в контуре (on-premise), автономно, без риска утечки данных и коммерческой тайны
Решение обрабатывает документы полностью локально внутри инфраструктуры заказчика без передачи данных во внешние сервисы. Это защищает конфиденциальную информацию от неавторизованного доступа и утечек, а также обеспечивает полное соответствие требованиям ИБ и законодательства в области обработки данных.
Отсутствие риска утечки:
работа OCR непосредственно на устройстве пользователя без передачи данных
Smart Engines – не сервис по обработке персональных данных. Мы поставляем решения, которые работают исключительно в информационном контуре Заказчика в полностью автоматическом режиме, без ручной верификации.
- Данные ваших клиентов не передаются на обработку ни нам, ни третьим лицам. Сетевое соединение не требуется
- Вся обработка ведется в локальной оперативной памяти устройств (100% on-premise)
- Не используется верификация операторами – HITL (human-in-the-loop), crowdsourcing, mechanical turk
ВАЖНО! О репутационных и финансовых рисках работы с сервисами распознавания.
Юристы предупреждают: никакие гарантии, сертификаты и прочие документы, предоставляемые сервисами обработки персональных данных и документов, составляющих коммерческую, служебную и государственную тайну, не защищают компании от репутационных рисков и финансовой ответственности при утечке данных.
Компании, передающие данные своих клиентов на обработку третьим лицам, в случае утечки лишаются права ссылаться на нарушение ее прав третьими лицами и всю ответственность перед контрагентами принимают на себя.
Вы можете ознакомиться с юридическим заключением компании INTELLECT, входящей в группу самых успешных российских юридических компаний по версии международного рейтинга The Chambers Europe.
Попробуйте качество наших технологий
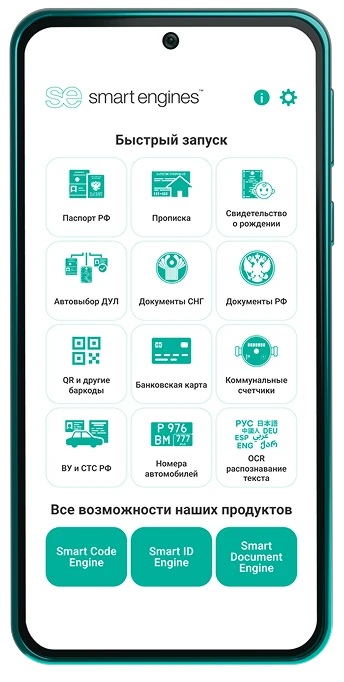
- Скачайте мобильное демо-приложение, в котором все возможности собраны воедино
- Можно на время отключить интернет, чтобы убедиться, что изображения и ваши данные не передаются
- Извлекайте данные паспортов, удостоверений личности и других документов. Пробуйте распознавать оригиналы и копии при различных условиях съемки


Заказать продукт
Часто задаваемые вопросы
Для каких агентных моделей ИИ подходит решение?
Система подходит для автоматизации ввода данных в любые LLM и агентные модели ИИ, построенные на их основе. Решение может использоваться как источник достоверных данных для корпоративных AI-платформ, интеллектуальных помощников, RAG-систем, NLP-моделей, AI-агентов для документооборота, KYC/KYB-сценариев и других систем анализа и принятия решений, работающих на основе текстовой информации из документов. Решение обеспечивает высокоточный структурированный ввод без искажения исходных данных, что особенно важно для ИИ-агентов, принимающих решения на основе содержимого документов.
Как система помогает повысить качество работы ИИ-агентов?
Технология Smart Engines позволяет существенно повысить качество работы ИИ-агентов за счет высокоточного и достоверного извлечения данных. Система обеспечивает максимальное качество распознавания без галлюцинаций и рисков искажения исходной информации. На выходе решение формирует расширенный результат распознавания: текст, знакоместа, геометрию документа и альтернативы для NLP-обработки. Это позволяет значительно точнее анализировать документы с помощью ИИ-агентов, учитывать контекст расположения данных и минимизировать ошибки интерпретации при автоматическом принятии решений.
Какой текст можно распознать с помощью решения?
Система Smart Engines распознает печатный, рукописный и смешанный текст любой сложности. Поддерживается обработка рукописных пометок, комментариев, анкет, заявлений, подписей и других текстовых элементов, заполненных от руки. Решение корректно работает даже с трудноразборчивым почерком, а также с текстом, написанным ручкой, карандашом или пером. Решение поддерживает распознавание смешанного текста в документах, где одновременно присутствуют печатные и рукописные фрагменты.
Подходит ли система для ввода данных деловых документов?
Да. Система Smart Engines автоматически определяет тип документа на фотографиях и сканах и извлекает ключевые реквизиты из различных типов документации. Решение поддерживает обработку 80+ видов деловых документов РФ, а также 3000+ типов удостоверений личности всего мира. OCR распознает и классифицирует договоры, счета, акты, анкеты, заявления, бухгалтерские и кадровые документы и другие формы документации. Технология поддерживает потоковую обработку больших массивов документов, ускоряя ввод данных, проверку, маршрутизацию и автоматизацию бизнес-процессов без участия человека.
Какие языки поддерживает технология распознавания?
Технология поддерживает распознавание текста более чем на 100 языках мира. Система эффективно работает не только с латиницей и кириллицей, но и со сложными системами письменности, включая арабскую вязь, китайские и японские иероглифы, корейское письмо и другие алфавиты. Поддерживается омнифонтовое распознавание независимо от гарнитуры, начертания и качества печати, что позволяет использовать решение в мультиязычных AI-сценариях.
Работает ли система с изображениями низкого качества?
Да. Технология с высочайшей точностью распознает документы, снятые в реальных условиях, и работает с изображениями низкого качества. Система автоматически выполняет локализацию документа в кадре, выравнивание и нормализацию изображения. Искусственный интеллект устойчив к шумам, бликам, теням, размытию, сложному фону и артефактам сканирования. Это позволяет одинаково эффективно обрабатывать как фотографии с мобильных устройств, так и низкокачественные сканы документов, обеспечивая высокую точность извлечения данных.
В каком виде решение возвращает результаты?
Система передает результаты распознавания в структурированном виде, подходящем для последующей обработки ИИ-агентами и NLP-системами. Вместе с извлеченным текстом решение возвращает знакоместа, геометрию документа и альтернативы. Такой уровень детализации позволяет применять технологию для ввода данных в существующие системы интеллектуального анализа документов и автоматического принятия решений, а также для построения мультиагентных моделей на базе AI.
Какую производительность обеспечивает система?
Решение Smart Engines обеспечивает сверхбыструю обработку документов — до 1800 страниц в минуту на одном сервере без использования GPU. Архитектура решения позволяет легко масштабировать систему для работы с большими объемами данных без усложнения ИТ-инфраструктуры и дополнительных затрат на специализированное оборудование. Высокая производительность системы делает решение эффективным инструментом для потоковой обработки документов, корпоративных AI-платформ и высоконагруженных систем, где критически важна скорость, полнота и достоверность данных.
Каковы инфраструктурные требования для работы решения?
Система Smart Engines — мультиплатформенный программный продукт, который быстро встраивается в существующую ИТ-инфраструктуру заказчика без необходимости доработок. Для работы решения не требуется интернет-соединение и привлечение мощностей графических ускорителей (GPU). Это позволяет применять систему как на серверах, так и на рабочих станциях, мобильных устройствах и на веб-страницах.
Подходит ли система для работы с конфиденциальной информацией?
Да. Решение работает полностью автономно в инфраструктуре заказчика по модели on-premise и обеспечивает 100% локальную обработку документов. Во время распознавания изображения и извлеченные данные не передаются за пределы защищенного контура организации и не отправляются во внешние облачные сервисы. Это обеспечивает высокий уровень конфиденциальности и соответствие требованиям информационной безопасности, что особенно важно для банков, государственных организаций, промышленности и корпоративных заказчиков.