


В соответствии с 98-ФЗ незаконное получение, использование или разглашение сведений, составляющих коммерческую тайну, может повлечь штраф до 5 млн рублей и лишение свободы на срок до 7 лет. Несоблюдение требований конфиденциальности и безопасности данных корпоративных документов, содержащих персональную информацию, по 152-ФЗ может привести к штрафам до 20 млн рублей, а при повторных нарушениях — оборотные штрафы до 500 млн рублей. При трансграничной передаче санкции включают лишение свободы на срок до 10 лет. Привлечение подрядчика к обработке не освобождает оператора от ответственности.

Как работает OCR распознавание текста
OCR система Smart Engines построена на собственной нейросетевой технологии оптического распознавания. Распознавание текста охватывает печатные и рукописные документы на 100+ языках — сканы, фотографии и PDF, в том числе низкого качества, снятые «на весу», с бликами, тенями и перекосами.
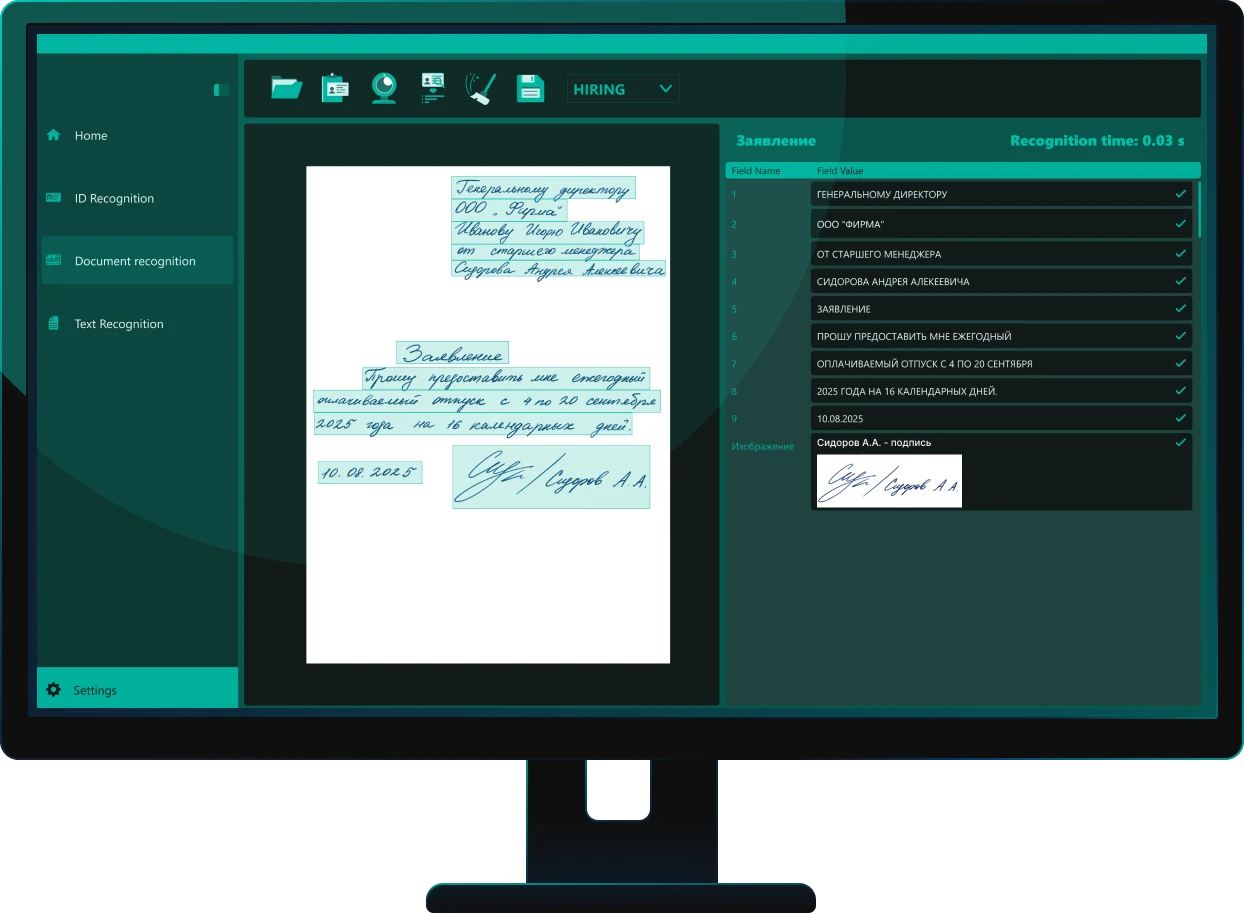
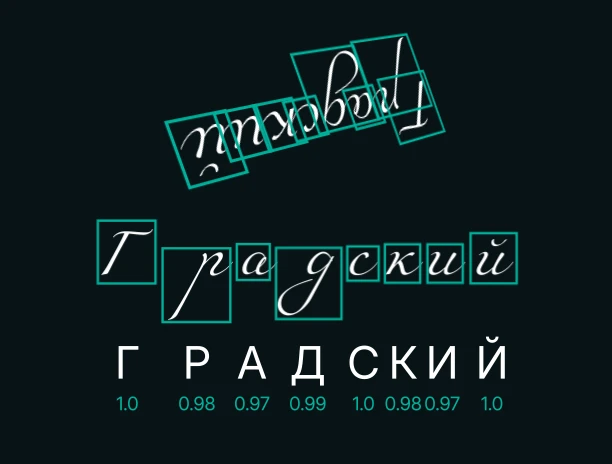
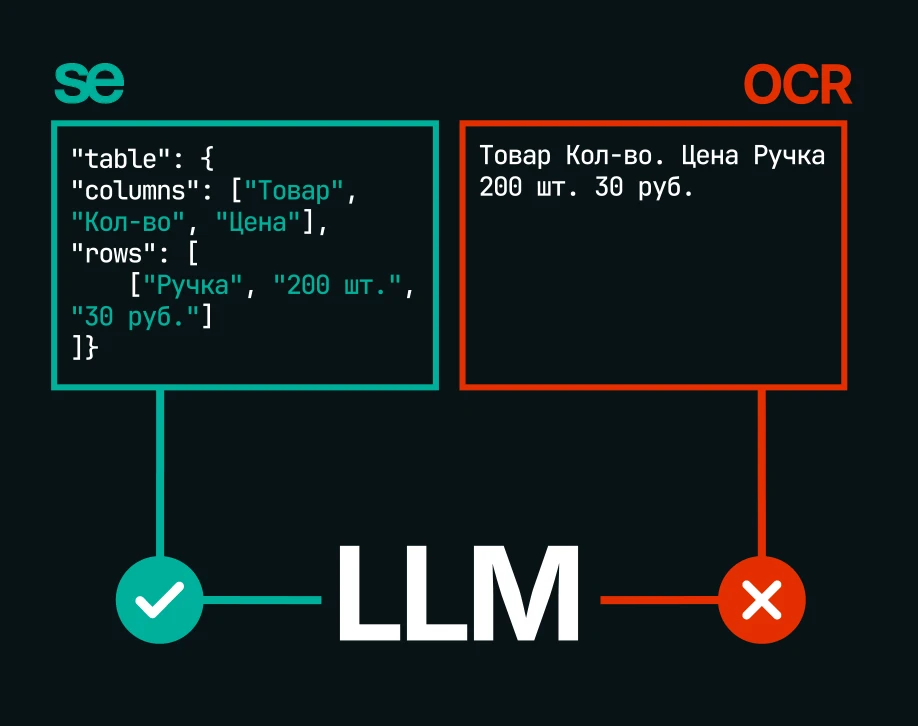
OCR распознавание выполняется без генеративных моделей внутри и без «додумывания»: система возвращает ровно то, что есть в документе, и по каждому символу дает численную метрику уверенности. Помимо текста, ПО разбирает структуру страницы — находит таблицы, печати, подписи и служебные отметки — и приводит извлеченные данные к целевому формату.
Решение работает в мобильных, веб-, десктопных и серверных приложениях, полностью автономно в контуре заказчика и без GPU. Скорость — более 100 тысяч страниц в час на одном сервере: этого достаточно для потокового OCR распознавания входящей корреспонденции, клиентских и финансовых документов с передачей в LLM, СЭД, ERP, CRM и электронные архивы.

Учредители — резиденты РФ

Собственная разработка

Запись 9617 в реестре ПО

Поддержка российских ОС
Возможности OCR-системы для распознавания текста
- OCR документа в мобильном, веб, десктоп и серверном приложении
- Распознавание сканов и фотографий низкого качества
- Поиск, выравнивание и нормализация документа на фотографии
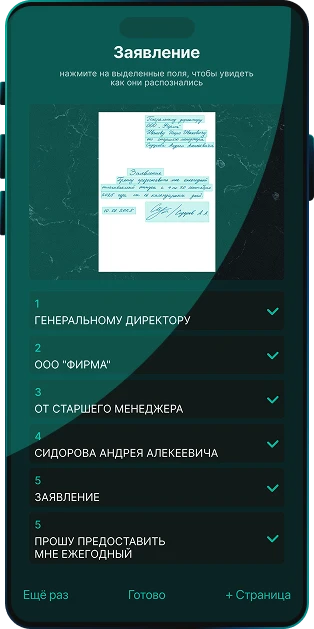
- Распознавание документа А4 на смартфоне за 2-3 секунды
- GreenOCR® — экологичный искусственный интеллект для распознавания текста
- Уникальные 4.6 битные нейросетевые модели для скоростного распознавания на CPU
- Распознавание силами CPU, не требует серверов с GPU и NPU
- Высокоточное распознавание текста на фото и скане
- Распознавание рукописных текстов, надписей и пометок вне зависимости от почерка
- Автоматизация ввода текста документов для СЭД и электронных архивов
- Новаторские малобитные и компактные нейросетевые модели
- Распознавание печатной и рукописной кириллической письменности
- Высокоточный OCR для всех языков, базирующихся на латинице
- Распознавание арабского, фарси, урду, бенгальского, тайского, сингальского и тамильского
- Распознавание японского, корейского и китайского языков
- Распознавание иврита, греческого, грузинского и армянского
- Распознавание многостраничных документов
- Поиск и распознавание таблиц
- Потоковое распознавание в контуре (on-premise) со скоростью более 100 тысяч страниц в час на сервере без GPU
- Надежное распознавание рукописи и печатного текста без лингвистических галлюцинаций
- AI модели обучены исключительно на синтетических данных
- Автоматическое определение типа документа
OCR-решения для бизнеса: где применяется распознавание текста
Ввод первичных документов
Счета, акты, накладные, УПД — распознавание реквизитов и табличных частей с передачей в 1С.

СЭД и ECM
Входящая корреспонденция и служебные записки: регистрация без ручного ввода карточки.
Электронные архивы
Ретроконверсия бумажных дел и рукописных документов в полнотекстовый поиск.
Кадровый документооборот
Паспорта РФ, СНГ, свидетельства ЗАГС, ИНН, дипломы, трудовые книжки и др.
Данные для LLM и ИИ-агентов
Любые документы в чистый структурированный текст без шума на входе модели.
Идентификация клиента
Паспорта и удостоверения личности 230+ стран в мобильном и серверном сценарии.
-
Ввод первичных документов
Счета, акты, накладные, УПД — распознавание реквизитов и табличных частей с передачей в 1С.
-
СЭД и ECM
Входящая корреспонденция и служебные записки: регистрация без ручного ввода карточки.
-
Электронные архивы
Ретроконверсия бумажных дел и рукописных документов в полнотекстовый поиск.
-
Кадровый документооборот
Паспорта РФ, СНГ, свидетельства ЗАГС, ИНН, дипломы, трудовые книжки и др.
-
Данные для LLM и ИИ-агентов
Любые документы в чистый структурированный текст без шума на входе модели.
-
Идентификация клиента
Паспорта и удостоверения личности 230+ стран в мобильном и серверном сценарии.
Возможности
интеграции OCR
TextEngine engine = TextEngine.Create(<PATH_TO_CONFIGURATION_FILE>, true);
TextSessionSettings settings = engine.CreateSessionSettings();
settings.SetOption("mode", "page");
settings.AddEnabledLanguages("rus:eng:punct:digits");

TextSession session = engine.SpawnSession(settings, <PERSONALIZED_SIGNATURE>);
Image image = Image.FromFile(<PATH_TO_IMAGE>);
session.ProcessImage(image);

TextResult result = session.GetCurrentResult();
TextScene scene = result.GetCurrentScene();
TextIterator iterator = scene.CreateIterator("default");
while(!iterator.Finished()) {
  String chunk = iterator.GetTextChunk().GetOcrString().GetFirstString().GetCStr();
  iterator.Advance();
}
std::unique_ptr<se::text::TextEngine> engine(se::text::TextEngine::Create(<PATH_TO_CONFIGURATION_FILE>, true));
std::unique_ptr<se::text::TextSessionSettings> settings(engine->CreateSessionSettings());
settings->SetOption("mode", "page");
settings->AddEnabledLanguages("rus:eng:punct:digits");
std::unique_ptr<se::text::TextSession> session(engine->SpawnSession(*settings, <PERSONALIZED_SIGNATURE>));
std::unique_ptr<se::common::Image> image(se::common::Image::FromFile(<PATH_TO_IMAGE>));
session->ProcessImage(*image);

const se::text::TextResult& result = session->GetCurrentResult();
const auto& scene = result.GetCurrentScene();
auto iterator = scene.CreateIterator("default");
for (; !iterator->Finished(); iterator->Advance()) {
  std::string chunk = iterator->GetTextChunk().GetOcrString().GetFirstString().GetCStr();
}
TextEngine engine = TextEngine.Create(<PATH_TO_CONFIGURATION_FILE>, true);
TextSessionSettings settings = engine.CreateSessionSettings();
settings.SetOption("mode", "page");
settings.AddEnabledLanguages("rus:eng:punct:digits");

TextSession session = engine.SpawnSession(settings, <PERSONALIZED_SIGNATURE>);
Image image = Image.FromFile(<PATH_TO_IMAGE>);
session.ProcessImage(image);

TextResult result = session.GetCurrentResult();
TextScene scene = result.GetCurrentScene();

for (TextIterator iterator = scene.CreateIterator("default"); !iterator.Finished(); iterator.Advance()) {
  String chunk = iterator.GetTextChunk().GetOcrString().GetFirstString().GetCStr();
}
engine = pytextengine.TextEngine.Create(<PATH_TO_CONFIGURATION_FILE>, True)
settings = engine.CreateSessionSettings()
settings.SetOption("mode", "page")
settings.AddEnabledLanguages("rus:eng:punct:digits")
session = engine.SpawnSession(settings, <PERSONALIZED_SIGNATURE>)
image = pytextengine.Image.FromFile(<PATH_TO_IMAGE>)
session.ProcessImage(image)

result = session.GetCurrentResult()
scene = result.GetCurrentScene()
iterator = scene.CreateIterator("default")
while not iterator.Finished():
  chunk = iterator.GetTextChunk().GetOcrString().GetFirstString().GetCStr()
  iterator.Advance()
Уверенность распознавания, координаты объектов, вырезание полей и документов
Возврат зоны принятия решения для проверок подлинности
Операционные системы
- Android
- iOS
- MS Windows
- Linux
- ОС Аврора
- ОС Эльбрус
- РЕД ОС
- Astra Linux
- ОС Атликс
- ОС Альт Линукс
Low-code интеграция, простой и понятный REST API
- API на
- C
- C++
- C#
- Java
- Python
- PHP
- Фреймворки:
- React Native
- Flutter
- интеграция с 1C
- Примеры использования на языках
- C
- C++
- C#
- Java
- Python
- PHP
Архитектуры процессоров
- х86
- x86_64
- ARMv7-v8-v9 (AArch32 и AArch64)
- MIPS (MIPS32 и MIPS64)
- Elbrus
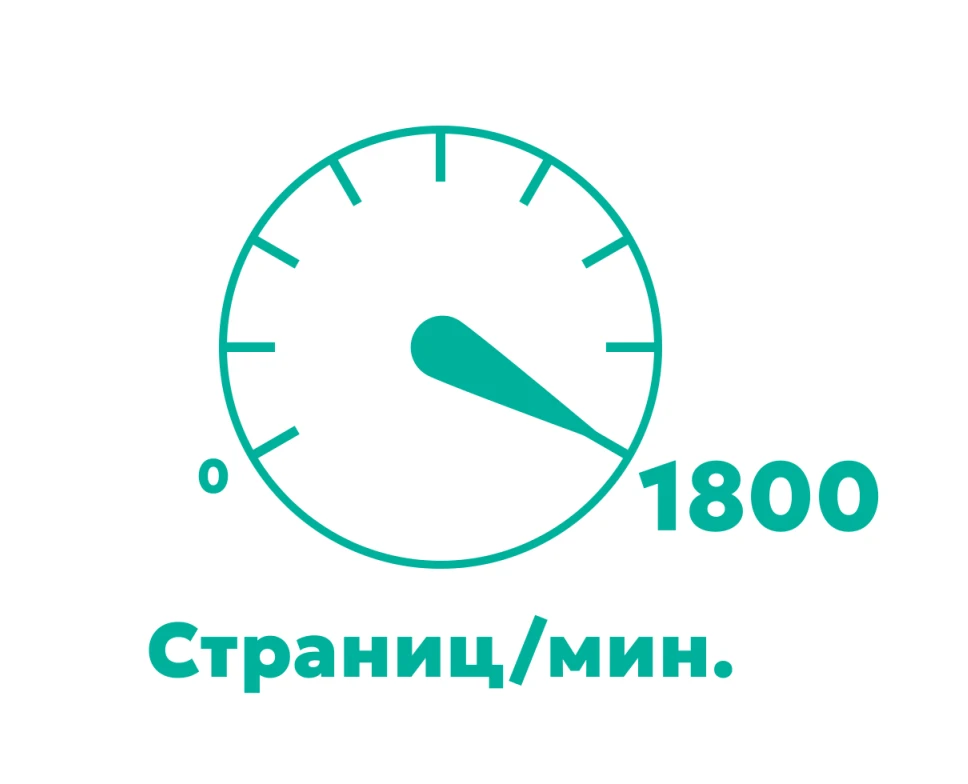
Скорость распознавания 1800 страниц в минуту на сервере без применения GPU
Система Smart Engines масштабируется под любые объемы бизнеса. ИИ обрабатывает до 600 тысяч страниц в сутки на одном сервере и до 16 млн страниц на кластере без использования графических процессоров (GPU) и усложнения ИТ-ландшафта. Решение обеспечивает высокое качество и непревзойденную скорость распознавания документов даже при пиковых нагрузках.
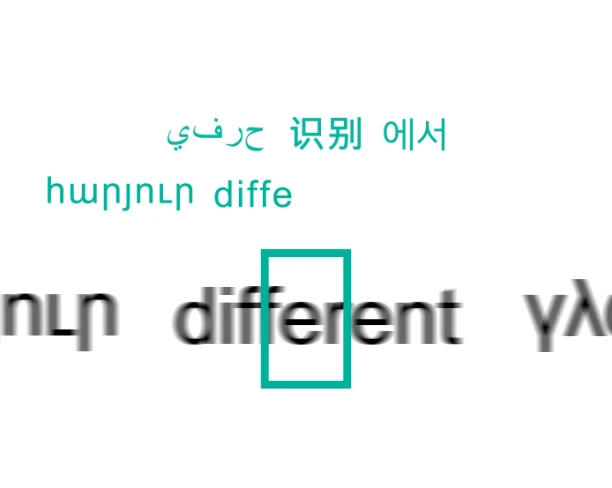
Омнифонтовое (шрифтонезависимое) распознавание текста документов на 100+ языках
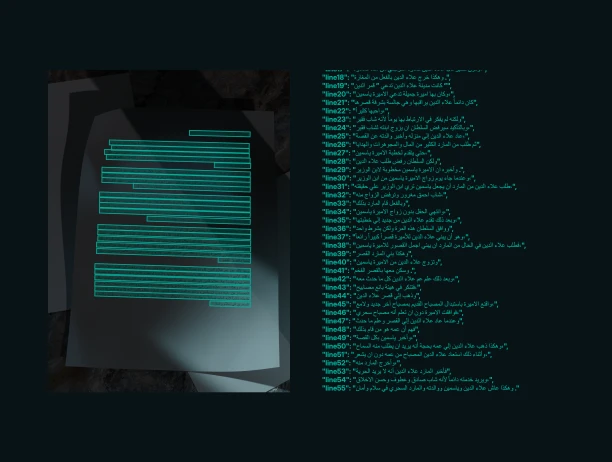
ИИ-система Smart Engines обеспечивает шрифтонезависимое (омнифонтовое) распознавание документов на более чем 100 языках — независимо от гарнитуры, начертания и качества печати. Решение одинаково точно работает с латиницей и кириллицей, а также с наиболее сложными системами письма — арабской вязью, иероглифами китайского и японского языков, корейским письмом и другими алфавитами.
Система оптического распознавания текста на базе собственной технологии OCR
В основе программного решения лежит собственная технология оптического распознавания текста (OCR), разработанная Smart Engines. Все используемые нейросетевые алгоритмы и программный код полностью созданы специалистами компании. Такой подход позволяет контролировать все этапы обработки данных без необходимости использования сторонних библиотек или сервисов.
Распознает сканы и фотографии низкого качества в реальных условиях
ИИ Smart Engines распознает сканы и фотографии в реальных условиях — включая изображения низкого качества. Алгоритмы устойчивы к шуму, размытию, перекосам и плохому освещению, что обеспечивает точное извлечение данных даже там, где традиционные OCR-решения теряют точность.
Распознавание полностью рукописных документов, смешанных текстов и пометок
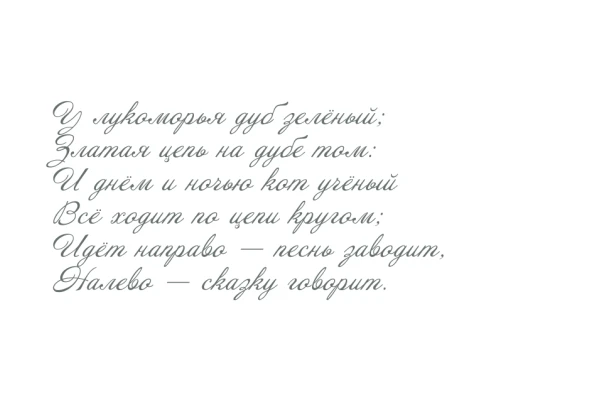
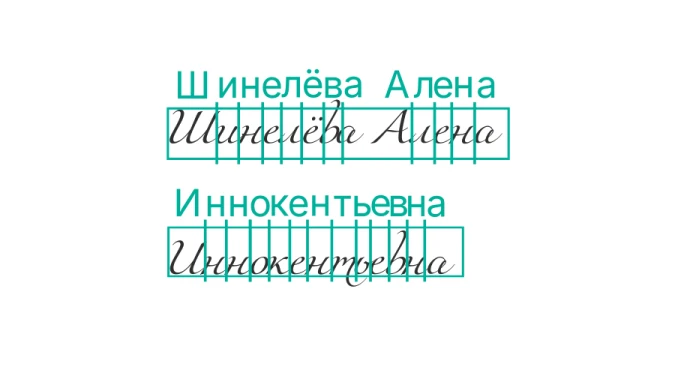
Система распознает печатные, рукопечатные и рукописные реквизиты с точностью до 99,9%. Алгоритмы ИИ позволяют считывать практически любой почерк — от аккуратного до трудноразборчивого — а также текст, написанный ручкой, карандашом или пером. Поддерживается распознавание пометок и комментариев на документах.
Распознавание без обработки — возвращает то, что на бумаге
Система Smart Engines извлекает данные из документов в исходном виде «как есть» (as is) — без какого-либо вмешательства в данные. В отличие от генеративных моделей, склонных к искажению данных и «галлюцинированию», такой подход обеспечивает точность и надежность, критичные для бизнес-процессов.
Минимальный футпринт — всего 2.7 Мб для веб-страниц и PWA
Минимальный футпринт — всего 2,7 МБ для веб-страниц и PWA — достигается за счет использования сверхкомпактных нейросетевых архитектур, оптимизированных по числу параметров и потреблению памяти. Это позволяет запускать модели непосредственно на устройстве, обеспечивая быструю работу на мобильных устройствах и даже в браузере без потери точности.
Распознавание текста, оптимизированное для работы с LLM
Система Smart Engines обеспечивает распознавание текста, оптимизированное для работы с большими языковыми моделями (LLM). Она формирует структурированный и высокоточный вывод данных без шума и искажений. Это упрощает интеграцию с языковыми моделями и повышает качество их работы.
Работа на серверах в контуре заказчика и на мобильных устройствах без интернета для выездных и удаленных сценариев проверки
Решение работает как на серверах компании, так и на десктопах, смартфонах и планшетах пользователей — интеграция возможна в мобильные приложения или браузер. Все вычисления выполняются локально — без передачи данных во внешние сервисы. Система подходит для выездных и удаленных сценариев проверки и не требует стабильного интернет-соединения.
Отсутствие риска утечки:
работа OCR непосредственно на устройстве пользователя без передачи данных
Smart Engines – не сервис по обработке персональных данных. Мы поставляем решения, которые работают исключительно в информационном контуре Заказчика в полностью автоматическом режиме, без ручной верификации.
- Данные ваших клиентов не передаются на обработку ни нам, ни третьим лицам. Сетевое соединение не требуется
- Вся обработка ведется в локальной оперативной памяти устройств (100% on-premise)
- Не используется верификация операторами – HITL (human-in-the-loop), crowdsourcing, mechanical turk
ВАЖНО! О репутационных и финансовых рисках работы с сервисами распознавания.
Юристы предупреждают: никакие гарантии, сертификаты и прочие документы, предоставляемые сервисами обработки персональных данных и документов, составляющих коммерческую, служебную и государственную тайну, не защищают компании от репутационных рисков и финансовой ответственности при утечке данных.
Компании, передающие данные своих клиентов на обработку третьим лицам, в случае утечки лишаются права ссылаться на нарушение ее прав третьими лицами и всю ответственность перед контрагентами принимают на себя.
Вы можете ознакомиться с юридическим заключением компании INTELLECT, входящей в группу самых успешных российских юридических компаний по версии международного рейтинга The Chambers Europe.
Попробуйте качество OCR распознавания
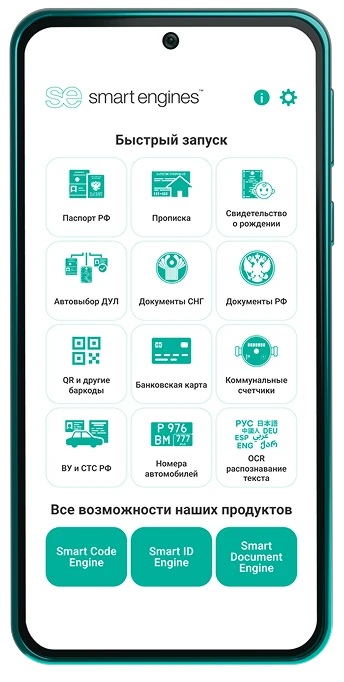
- Скачайте мобильное демо-приложение, в котором все возможности собраны воедино
- Можно на время отключить интернет, чтобы убедиться, что изображения и ваши данные не передаются
- Извлекайте данные паспортов, удостоверений личности и других документов. Пробуйте распознавать оригиналы и копии при различных условиях съемки.


Заказать продукт
Часто задаваемые вопросы
Какие языки поддерживаются системой распознавания?
Программный продукт поддерживает более 100 языков распознавания. Помимо привычных языков, базирующихся на кириллических и латинских алфавитах, решение распознает любые тексты на арабском, китайском, грузинском, армянском, греческом, иврите, корейском и других языках со сложными графическими системами.
Может ли решение распознать рукописный текст?
Да. Решение с высокой точностью распознает даже трудноразборчивый рукописный текст, написанный ручкой, карандашом или пером. Поддерживается распознавание букв, цифр и их комбинаций, включая сложные и трудночитаемые слова (например, со схожими символами «ш», «л», «и», «п»), без использования словарей и языковых моделей. Это позволяет извлекать абсолютно всю информацию со страницы, избегая потери значимых сведений.
Распознает ли система таблицу, печать или подпись?
Да. Система понимает структуру документа и распознает любые графические элементы, включая сложные табличные формы, печати и подписи. Механизм пространственного внимания позволяет ИИ «фокусировать взгляд» на наиболее значимых областях и игнорировать второстепенный фон. За счет этого система в автоматическом режиме проверяет наличие нужных подписей и подтверждает правильность оформления документов.
Работает ли решение на мобильном телефоне?
Да. В основе решения лежит комплекс сверхкомпактных нейросетевых архитектур, за счет чего задачи распознавания выполняются прямо на CPU мобильного телефона, планшета или ноутбука. Для извлечения текста достаточно просто навести камеру смартфона на документ — система распознает его содержание менее чем за секунду даже без стабильного интернет-соединения.
Как система борется с галлюцинациями?
Программный продукт извлекает данные из документов в исходном виде «как есть» (as is), без какого-либо вмешательства в данные. Это отличает его от генеративных моделей, склонных к «додумыванию» в условиях отсутствия информации.
Что такое OCR и чем оно отличается от обычного сканирования?
OCR (Optical Character Recognition) — оптическое распознавание символов, при котором изображение документа преобразуется в машиночитаемый текст. Обычный сканер создает только картинку: по ней нельзя выполнить поиск, скопировать фрагмент или передать данные в учетную систему. OCR распознавание превращает изображение в текст для автоматической обработки.
Чем OCR система Smart Engines отличается от других решений для распознавания текста?
OCR система Smart Engines построена на собственных нейросетевых архитектурах и не использует сторонние библиотеки и облачные сервисы. Уникальные 4,6-битные модели выполняют распознавание текста силами CPU, без GPU и NPU, а футпринт в 2,7 МБ позволяет запускать OCR прямо в браузере или мобильном приложении. Модели обучены на синтетических данных, а отсутствие генеративных моделей внутри исключает галлюцинации при извлечении реквизитов.
Распознает ли решение фотографии или сканы низкого качества?
Да. Система нетребовательна к качеству поступающих изображений и сканов — текст извлекается даже с фотографий, снятых с камеры бюджетного смартфона. Решение устойчиво к съемке «на весу», шумам, размытиям, перекосам, плохому освещению, контрастным теням и бликам. Система поддерживает как фотографии, сканы, так и видеопоследовательности.
Какие форматы файлов поддерживаются?
Система поддерживает все основные форматы файлов и изображений: PDF, JPEG (JPG), PNG, TIFF, а также сканы и фотографии документов. Решение может обрабатывать как одностраничные, так и многостраничные документы. Это делает систему применимой в любых сценариях — от мобильного ввода до массовой потоковой обработки документов.
С какой скоростью и точностью работает система распознавания?
Система масштабируется под любые объемы бизнеса и способна извлечь до 600 тысяч страниц в сутки на одном сервере и до 16 млн страниц на кластере без использования графических процессоров (GPU). Точность распознавания текста достигает 99,9%, а алгоритмы ИИ построены на научных принципах достоверности и интерпретируемости — по каждому символу можно получить численную метрику уверенности в результате.
Использует ли система облака или внешние серверы для хранения и обработки данных?
Нет. Система является on-premise-решением, а извлеченные данные, фотографии и сканы документов не покидают контур компании. Для задач распознавания ИИ не требуются внешние вычислительные ресурсы — облака или краудсорсинговые платформы — это обеспечивает безопасность обработки персональных данных клиентов.
Возможна ли интеграция с учетными системами (1С, ERP)?
Да. Программный продукт бесшовно интегрируется с 1С и ERP-системами, что позволяет быстро направить данные в целевые бизнес-процессы без доработок и усложнения текущих операций. Интеграция происходит через REST API или любые другие стандартные интерфейсы, а извлеченные системой данные автоматически передаются в корпоративные системы без необходимости ручных корректировок.
Чем распознавание информации отличается от распознавания текста?
Распознавание текста возвращает символы и строки в том виде, в каком они присутствуют на изображении. Распознавание информации — следующий шаг: система разбирает структуру страницы, находит таблицы, печати и подписи, что позволяет извлекать в решениях Smart Engines целевую информацию.
Можно ли протестировать OCR распознавание перед покупкой?
Да. Доступно бесплатное мобильное демо-приложение в App Store, Google Play и RuStore: качество OCR распознавания можно проверить на собственных документах, в том числе с отключенным интернетом. Для пилотного проекта предоставляется полнофункциональная триал-версия SDK — заявку можно оставить в форме на этой странице.