


В соответствии с 98-ФЗ незаконное получение, использование или разглашение сведений, составляющих коммерческую тайну, может повлечь штраф до 5 млн рублей и лишение свободы на срок до 7 лет. Несоблюдение требований конфиденциальности и безопасности данных корпоративных документов, содержащих персональную информацию, по 152-ФЗ может привести к штрафам до 20 млн рублей, а при повторных нарушениях — оборотные штрафы до 500 млн рублей. При трансграничной передаче санкции включают лишение свободы на срок до 10 лет. Привлечение подрядчика к обработке не освобождает оператора от ответственности.

Как работает распознавание для СЭД и ECM
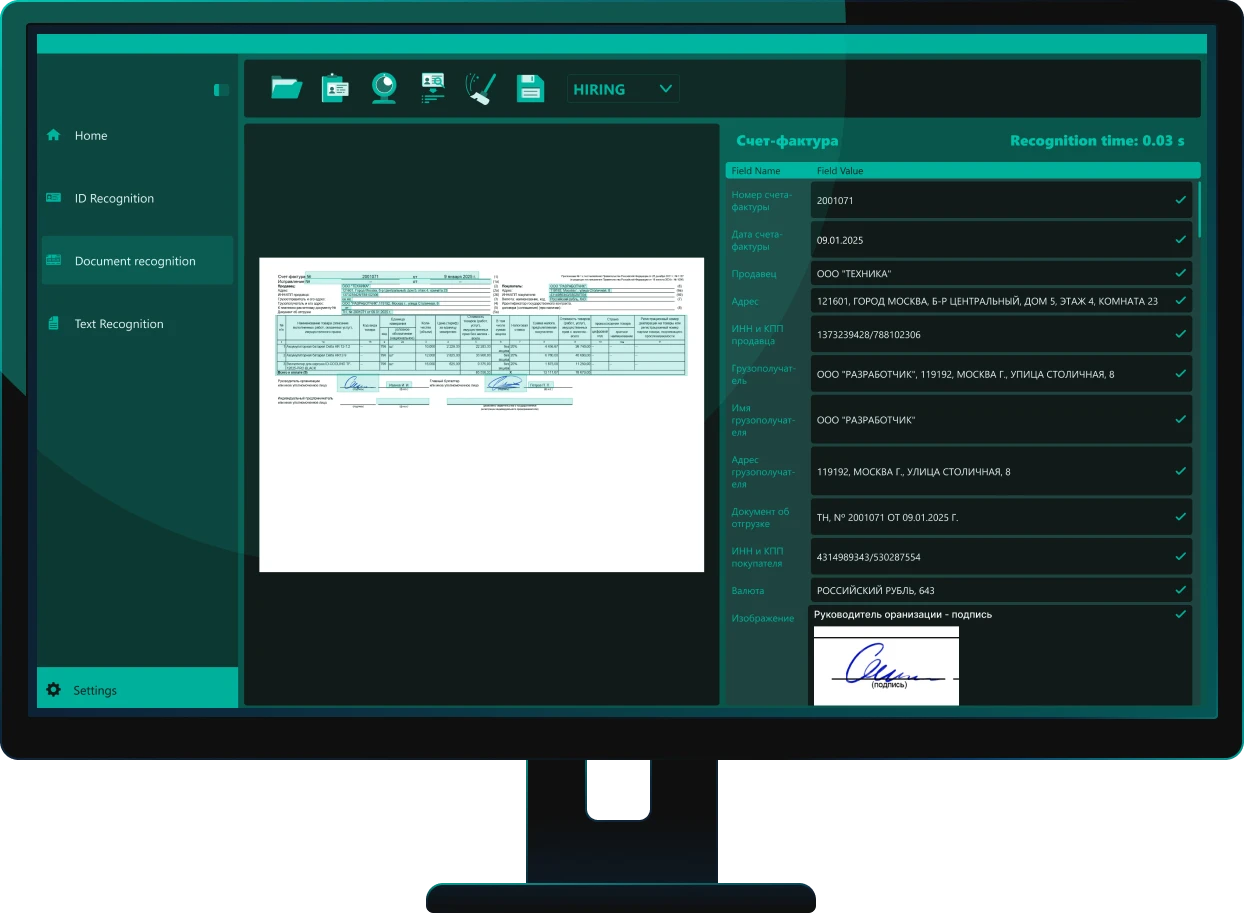
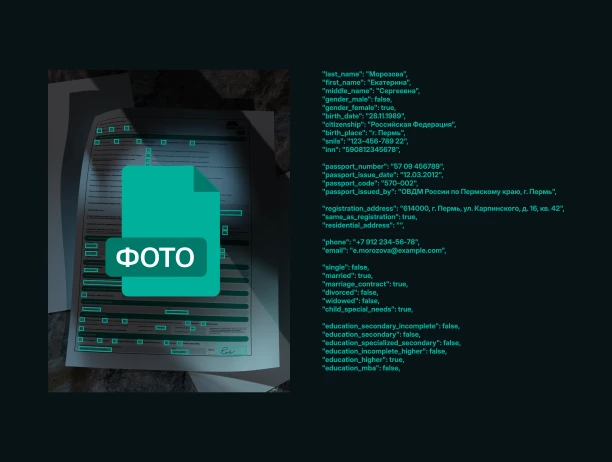
Программное обеспечение на базе искусственного интеллекта для распознавания в СЭД и ECM позволяет автоматически вводить документы в цифровой контур организации без ручной обработки. Решение классифицирует бухгалтерские и корпоративные документы, извлекает реквизиты, подготавливает материалы к регистрации в системе, распознает входящую корреспонденцию с экспортом в PDF с текстовым слоем. Система работает со сканами, фотографиями и многостраничными PDF, включая изображения низкого качества. Используются современные методы бинаризации, выравнивания и нормализации документов, а также компактные 4.6-битные нейросети для быстрого распознавания на CPU без GPU. ПО работает полностью в контуре заказчика, обрабатывая до 1800 страниц в минуту на сервере.

Учредители — резиденты РФ

Собственная разработка

Запись 9617 в реестре ПО

Поддержка российских ОС
Возможности распознавания
- Автоматическая классификация бухгалтерских и корпоративных документов перед загрузкой в СЭД и ECM
- Извлечение реквизитов для заполнения регистрационных карточек
- Подготовка документов к регистрации в системе без ручного ввода
- Обработка сканов, фотографий и многостраничных PDF-документов
- Потоковое распознавание больших массивов документов и архивов
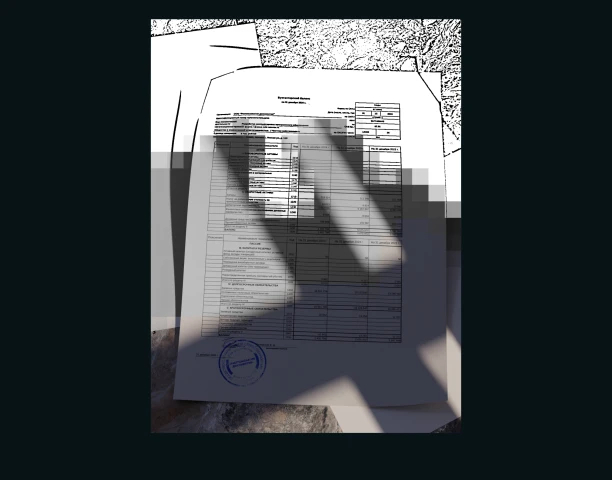
- Распознавание сканов и фотографий низкого качества
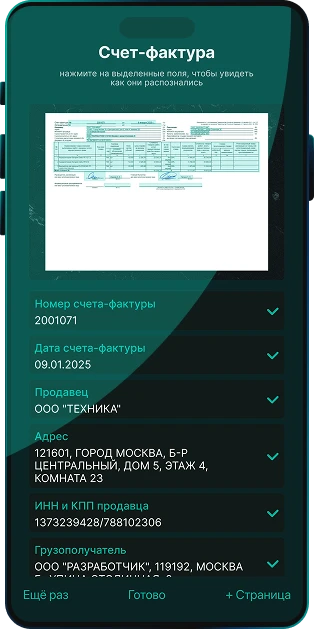
- Поиск, выравнивание и нормализация документа на фотографии
- Распознавание документа А4 на смартфоне за 2-3 секунды
- GreenOCR® — экологичный искусственный интеллект распознавания текста
- Уникальные 4.6 битные нейросетевые модели для скоростного распознавания на CPU
- Распознавание силами CPU, не требует ресурсов GPU и NPU
- Высокоточное распознавание текста на фото и скане
- Полнотекстовое распознавание бумажных архивов с экспортом в PDF с текстовым слоем
- State-of-the-art бинаризация изображений корпоративных документов
- Автоматическое определение типа документа
- Выравнивание, разглаживание и нормализация изображений документов
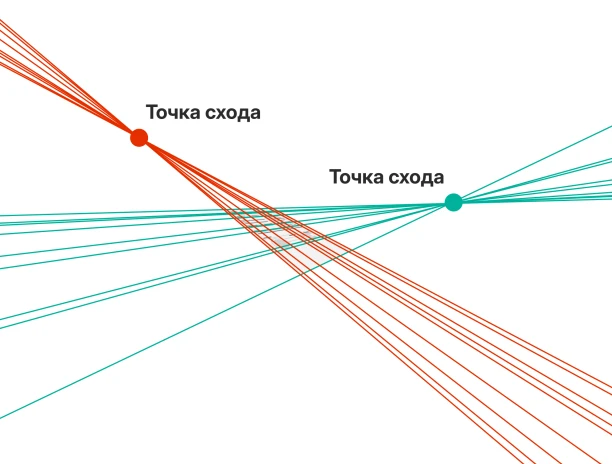
- Поиск границ документа на фото и автоматическая коррекция перспективы
- Высокоточное распознавание печатного текста на документах различного качества
- Распознавание таблиц, штампов, печатей, пометок и служебных отметок
- Распознавание полностью рукописных документов, смешанных текстов и пометок
- Работа полностью в контуре заказчика без передачи данных во внешние сервисы
- Высокая производительность обработки архивных и текущих потоков документов на CPU
Какие документы
распознаются
- Универсальный передаточный документ (УПД)
- Товарно-транспортная накладная (ТТН)
- Счет-фактура (включая исправленный счет-фактуру)
- Корректировочный счет-фактура
- ТОРГ-12
- УКД
- ТОРГ-13
- 2-НДФЛ
- Платежное поручение
- Платежное требование
- Платежный ордер
- Банковский ордер
- Инкассовое поручение
- ЕГРИП
- ЕГРЮЛ
- Сертификат самозанятого
- Бух. баланс
- ИНН юр.лица
- Акт передачи прав (шаблон 1С)
- Счет
- Акт
- Акт сверки
- Справка КС-3
- Акт КС-2
- Акт МХ-1
- Акт МХ-3
- Акт ОС-1
- Акт ОС-1а
- Акт ОС-4
- Акт ОС-15
- Свидетельство ОГРН
- Свидетельство ОГРНИП
- Справка-расчет рублевых сумм документа в валюте
- Книга покупок
- Справка о доходах по налогу на профессиональный доход
- Реестр сертификатов и деклараций (приложение к накладной)
- Отчет о финансовых результатах
- Устав компании
- Приказ о назначении генерального директора
- ЕГРН
- Транспортная накладная (от 2021 года)
- Приказ (распоряжение) о приеме работника на работу (Форма Т-1)
- Личная карточка работника (Форма Т-2)
Возможности
интеграции
DocEngine engine = DocEngine.Create(<PATH_TO_CONFIGURATION_FILE>, true);
DocSessionSettings settings = engine.CreateSessionSettings();
settings.SetCurrentMode("primary_accounting");
settings.AddEnabledDocumentTypes("*");
DocSession session = engine.SpawnSession(settings, <PERSONALIZED_SIGNATURE>);
DocProcessingSettings proc_settings = session.CreateProcessingSettings();
Image image = Image.FromFile(<PATH_TO_IMAGE>);
session.ProcessImage(image, proc_settings);

DocResult result = session.GetCurrentResult();
Document doc = result.DocumentsBegin().GetDocument();
for (DocTextFieldsIterator iterator = doc.TextFieldsBegin(); !iterator.Equals(doc.TextFieldsEnd()); iterator.Advance()) {
  String name = iterator.GetField().GetBaseFieldInfo().GetName();
  String value = iterator.GetField().GetOcrString().GetFirstString().GetCStr();
}
std::unique_ptr<se::doc::DocEngine> engine(se::doc::DocEngine::Create(<PATH_TO_CONFIGURATION_FILE>, true));
std::unique_ptr<se::doc::DocSessionSettings> settings(engine->CreateSessionSettings());
settings->SetCurrentMode("primary_accounting");
settings->AddEnabledDocumentTypes("*");
std::unique_ptr<se::doc::DocSession> session(engine->SpawnSession(*settings, <PERSONALIZED_SIGNATURE>));
std::unique_ptr<se::doc::DocProcessingSettings> proc_settings(session->CreateProcessingSettings());
std::unique_ptr<se::common::Image> image(se::common::Image::FromFile(<PATH_TO_IMAGE>));
session->ProcessImage(*image, proc_settings.get());

const se::doc::DocResult& result = session->GetCurrentResult();
const se::doc::Document& doc = result.DocumentsBegin().GetDocument();
for (auto iterator = doc.TextFieldsBegin(); iterator != doc.TextFieldsEnd(); ++iterator) {
  std::string name = iterator.GetFieldPtr()->GetBaseFieldInfo().GetName();
  std::string value = iterator.GetFieldPtr()->GetOcrString().GetFirstString().GetCStr();
}
DocEngine engine = DocEngine.Create(<PATH_TO_CONFIGURATION_FILE>, true);
DocSessionSettings settings = engine.CreateSessionSettings();
settings.SetCurrentMode("primary_accounting");
settings.AddEnabledDocumentTypes("*");
DocSession session = engine.SpawnSession(settings, <PERSONALIZED_SIGNATURE>);
DocProcessingSettings proc_settings = session.CreateProcessingSettings();
Image image = Image.FromFile(<PATH_TO_IMAGE>);
session.ProcessImage(image, proc_settings);

DocResult result = session.GetCurrentResult();
Document doc = result.DocumentsBegin().GetDocument();
for (DocTextFieldsIterator iterator = doc.TextFieldsBegin(); !iterator.Equals(doc.TextFieldsEnd()); iterator.Advance()) {
  String name = iterator.GetField().GetBaseFieldInfo().GetName();
  String value = iterator.GetField().GetOcrString().GetFirstString().GetCStr();
}
engine = pydocengine.DocEngine.Create(<PATH_TO_CONFIGURATION_FILE>, True)
settings = engine.CreateSessionSettings()
settings.SetCurrentMode("primary_accounting")
settings.AddEnabledDocumentTypes("*")
session = engine.SpawnSession(settings, <PERSONALIZED_SIGNATURE>)
proc_settings = session.CreateProcessingSettings()
image = pydocengine.Image.FromFile(<PATH_TO_IMAGE>)
session.ProcessImage(image, proc_settings)

result = session.GetCurrentResult()
doc = result.DocumentsBegin().GetDocument()
iterator = doc.TextFieldsBegin()
while(iterator != doc.TextFieldsEnd()):
  name = iterator.GetField().GetBaseFieldInfo().GetName()
  value = iterator.GetField().GetOcrString().GetFirstString().GetCStr()
  iterator.Advance()
Уверенность распознавания, координаты объектов, вырезание полей и документов
Возврат зоны принятия решения для проверок подлинности
Операционные системы
- Android
- iOS
- MS Windows
- Linux
- ОС Аврора
- ОС Эльбрус
- РЕД ОС
- Astra Linux
- ОС Атликс
- ОС Альт Линукс
Low-code интеграция, простой и понятный REST API
- API на
- C
- C++
- C#
- Java
- Python
- PHP
- Фреймворки:
- React Native
- Flutter
- интеграция с 1C
- Примеры использования на языках
- C
- C++
- C#
- Java
- Python
- PHP
Архитектуры процессоров
- х86
- x86_64
- ARMv7-v8-v9 (AArch32 и AArch64)
- MIPS (MIPS32 и MIPS64)
- Elbrus
Извлечение реквизитов, классификация и подготовка документов к регистрации в системе
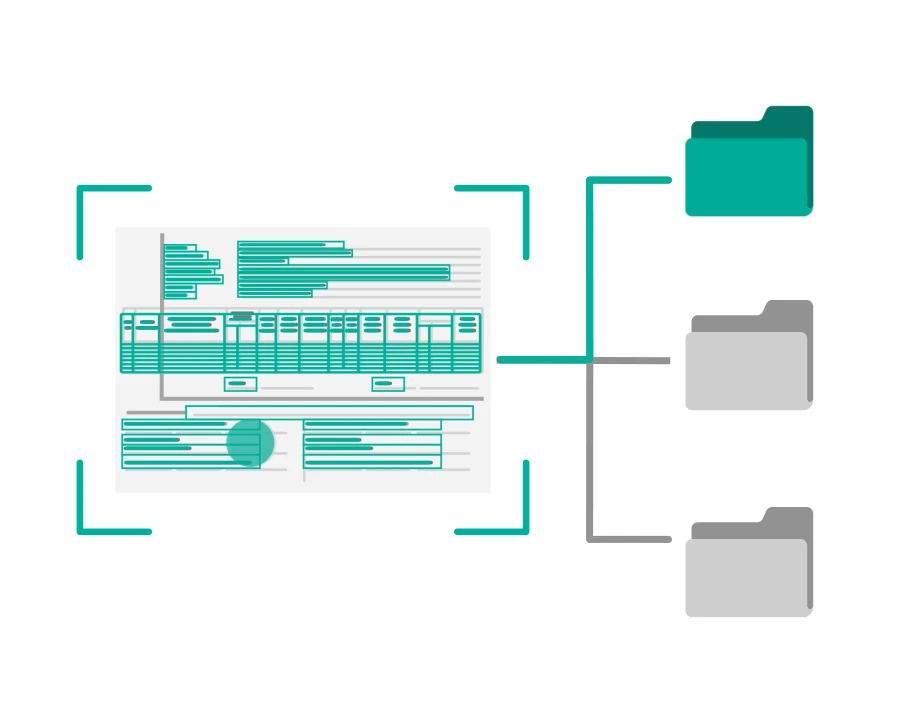
Искусственный интеллект автоматически определяет тип документа, извлекает ключевые реквизиты и подготавливает данные для регистрации в СЭД и ECM-системах без ручного ввода. Решение распознает договоры, счета, акты, письма, заявления, кадровые и бухгалтерские документы, формируя структурированный результат. Это позволяет сократить время регистрации документов, снизить количество ошибок ручного ввода и ускорить обработку входящего потока документов.
Уникальные Хаф-сети для выравнивания и разглаживания изображений документов
Технология Smart Engines применяет уникальные Хаф-сети для интеллектуального выравнивания, разглаживания и нормализации изображений документов перед распознаванием. Алгоритмы ИИ автоматически устраняют перекосы, деформации страниц, изгибы бумаги и геометрические искажения, возникающие при сканировании и мобильной съемке. Это обеспечивает высокую точность извлечения данных даже при работе с документами, снятыми в «неидеальных» условиях.
Автоматический ввод изображений документов в СЭД/ECM без ручной обработки
Система обеспечивает полностью автоматический ввод документов на сканах и фотографиях в СЭД и ECM-платформы без необходимости ручной сортировки и перепечатки данных. Искусственный интеллект извлекает реквизиты документа и предоставляет структурированный результат для интеграции в корпоративные системы. Решение позволяет значительно снизить нагрузку на сотрудников, ускорить обработку документов и повысить качество данных в цифровом архиве компании.
State-of-the-art методы бинаризации изображений корпоративных документов
Система Smart Engines использует современные алгоритмы бинаризации изображений для повышения качества распознавания корпоративных документов любой сложности. Искусственный интеллект надежно распознает документы, даже если на изображении присутствуют шумы, артефакты сканирования и дефекты печати. Это обеспечивает высокоточное распознавание данных даже при работе с частично поврежденными документами.
Автоматическое распознавание входящей корреспонденции для канцелярии
Технология Smart Engines автоматизирует обработку входящей корреспонденции для канцелярий, сервисных центров и других отделов. Искусственный интеллект распознает письма, обращения, заявления и сопроводительные документы, автоматически извлекая данные отправителя, дату, номер и другие реквизиты для регистрации в СЭД. Это позволяет сократить время обработки входящих документов и ускорить маршрутизацию документов между подразделениями.
Высокая производительность обработки больших массивов архивных документов
Архитектура Smart Engines обеспечивает высокоскоростную обработку больших массивов документов для массовой оцифровки архивов и потокового ввода данных в СЭД/ECM. Решение эффективно масштабируется под любые корпоративные нагрузки и позволяет обрабатывать сотни тысяч страниц без использования GPU и усложнения инфраструктуры. Высокая производительность системы помогает ускорить цифровую трансформацию документооборота и снизить затраты на обработку архивов.
Работа со сканами, фотографиями и многостраничными PDF
Система поддерживает все основные форматы файлов и изображений: JPEG (JPG), PNG, TIFF, многостраничные PDF, а также сканы и фотографии документов. Искусственный интеллект автоматически извлекает текст и реквизиты независимо от качества входящего изображения. Это позволяет применять решение для потоковой оцифровки архивов, ввода данных из документов с помощью мобильных устройств, а также в других корпоративных сценариях.
Распознавания бумажных архивов предприятия с экспортом в PDF с текстовым слоем
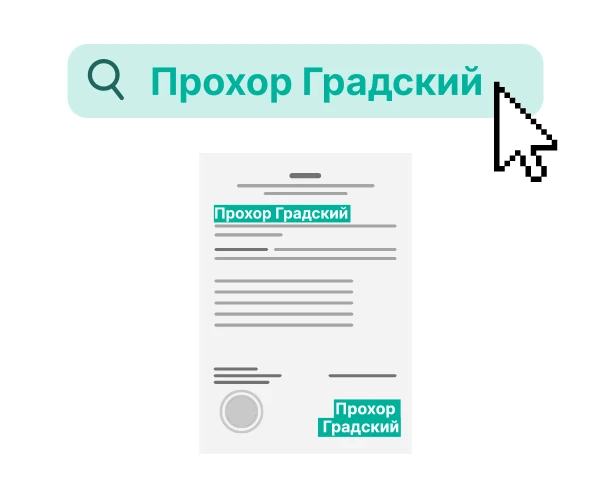
Технология Smart Engines подходит для массовой оцифровки бумажных архивов предприятий с возможностью автоматического экспорта в PDF с текстовым слоем. Система распознает содержимое архивных документов, делая их доступными для полнотекстового поиска, индексации и быстрого доступа из ECM-систем. Это позволяет существенно сократить время работы с архивами, ускорить поиск информации и быстро переводить бумажные фонды в цифровой формат без ручной обработки документов.
Работа полностью в контуре заказчика без передачи данных во внешние сервисы
Система Smart Engines работает полностью локально в инфраструктуре организации без передачи документов и данных во внешние облачные сервисы. Обработка выполняется внутри защищенного контура заказчика, что обеспечивает высокий уровень конфиденциальности и соответствие требованиям информационной безопасности. Решение подходит для банков, государственных организаций, промышленности и компаний, работающих с коммерческой тайной и персональными данными.
Отсутствие риска утечки:
работа OCR непосредственно на устройстве пользователя без передачи данных
Smart Engines – не сервис по обработке персональных данных. Мы поставляем решения, которые работают исключительно в информационном контуре Заказчика в полностью автоматическом режиме, без ручной верификации.
- Данные ваших клиентов не передаются на обработку ни нам, ни третьим лицам. Сетевое соединение не требуется
- Вся обработка ведется в локальной оперативной памяти устройств (100% on-premise)
- Не используется верификация операторами – HITL (human-in-the-loop), crowdsourcing, mechanical turk
ВАЖНО! О репутационных и финансовых рисках работы с сервисами распознавания.
Юристы предупреждают: никакие гарантии, сертификаты и прочие документы, предоставляемые сервисами обработки персональных данных и документов, составляющих коммерческую, служебную и государственную тайну, не защищают компании от репутационных рисков и финансовой ответственности при утечке данных.
Компании, передающие данные своих клиентов на обработку третьим лицам, в случае утечки лишаются права ссылаться на нарушение ее прав третьими лицами и всю ответственность перед контрагентами принимают на себя.
Вы можете ознакомиться с юридическим заключением компании INTELLECT, входящей в группу самых успешных российских юридических компаний по версии международного рейтинга The Chambers Europe.
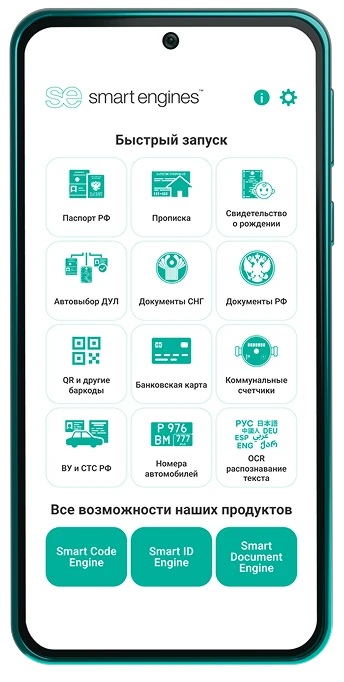
Попробуйте качество наших технологий
- Скачайте мобильное демо-приложение, в котором все возможности собраны воедино
- Можно на время отключить интернет, чтобы убедиться, что изображения и ваши данные не передаются
- Извлекайте данные паспортов, удостоверений личности и других документов. Пробуйте распознавать оригиналы и копии при различных условиях съемки.


Заказать продукт
Часто задаваемые вопросы
Какие задачи можно автоматизировать с помощью распознавания документов в СЭД и ECM?
Система позволяет автоматически вводить данные из документов в цифровой контур организации без ручной обработки. Решение классифицирует бухгалтерские, кадровые и корпоративные документы, извлекает реквизиты и возвращает структурированные данные для регистрации в СЭД/ECM. Это помогает ускорить обработку входящего потока документов, избежать ошибок ручного ввода и повысить качество данных в корпоративных ИС.
Какие форматы изображений и файлов поддерживает решение?
Система поддерживает все основные форматы файлов и изображений: JPEG (JPG), PNG, TIFF, PDF, а также сканы и фотографии архивных документов. Решение автоматически распознает все данные из одностраничных и многостраничных документов. Искусственный интеллект автоматически извлекает текст и реквизиты независимо от формата файла и качества изображения.
Подходит ли решение для оцифровки бумажных архивов?
Да. Технология Smart Engines предназначена для высокоточной потоковой оцифровки архивов и бумажных фондов в компаниях. Система выполняет полнотекстовое распознавание архивных документов с экспортом в PDF с текстовым слоем, делая возможным поиск по словам и ключевым фразам и быстрый доступ из ECM-систем. Решение помогает значительно ускорить цифровизацию архивов и сократить затраты на перенос документов в цифровой формат.
Подходит ли система для автоматизации обработки входящей корреспонденции?
Да. Система автоматически распознает входящую корреспонденцию любого типа: письма, заявления, обращения, сопроводительные документы и внутренние служебные материалы. Искусственный интеллект извлекает реквизиты отправителя, дату, регистрационные номера, содержимое документов и другую информацию для последующей регистрации в СЭД. Это позволяет ускорить документооборот и минимизировать ошибки при обработке входящих писем.
Какую производительность обеспечивает решение при обработке документов?
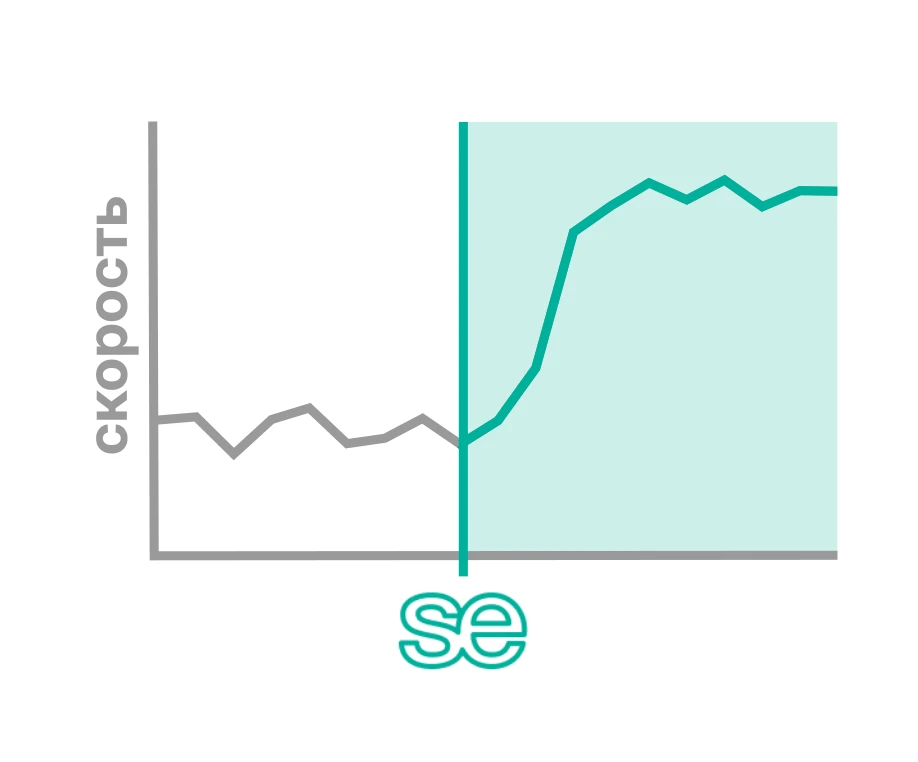
Технология Smart Engines обрабатывает до 1800 страниц в минуту на одном сервере без GPU и масштабируется под любые корпоративные нагрузки. Применение сверхкомпактных 4.6-битных нейросетей позволяет минимизировать требования к инфраструктуре и сократить затраты на внедрение и эксплуатацию системы в компаниях.
Можно ли применять систему для обработки поврежденных документов и низкокачественных изображений?
Да. Система использует методы бинаризации изображений документов, а также интеллектуальные алгоритмы выравнивания, разглаживания и нормализации. Искусственный интеллект автоматически устраняет шумы, артефакты сканирования, дефекты печати, а также перекосы и искажения, обеспечивая высокое качество распознавания даже старых и частично поврежденных документов.
Может ли система распознать документы, снятые на телефон в плохих условиях?
Да. Технология автоматически выполняет поиск границ и коррекцию проективных искажений документа на фотографиях. Алгоритмы ИИ автоматически устраняют артефакты, возникающие при мобильной съемке, и обеспечивают высокоточное извлечение данных из документов, сфотографированных в условиях реальной жизни.
Насколько точно система распознает текст на документах низкого качества?
Решение обеспечивает высокоточное распознавание печатного и рукописного текста из документов с качеством до 99,9%. Система надежно работает со сканами и фотографиями с шумами, бликами, тенями, размытием и дефектами печати. Алгоритмы искусственного интеллекта обеспечивают автоматическое извлечение данных даже из документов на изображениях низкого качества.
Поддерживает ли решение распознавание таблиц, печатей, штампов и рукописных пометок?
Да. Искусственный интеллект распознает таблицы, штампы, печати, служебные отметки, рукописные пометки и полностью рукописные документы. Система возвращает результаты распознавания в структурированном виде для быстрой интеграции в СЭД и ECM. Решение поддерживает обработку печатных, рукописных и смешанных текстов, где одновременно присутствуют печатные и рукописные фрагменты.
Подходит ли система для оцифровки конфиденциальных документов?
Да. Решение распознает документы полностью в защищенном контуре заказчика без передачи изображений и данных на внешние серверы. Все документы и извлеченные данные обрабатываются локально внутри инфраструктуры организации без отправки в облачные сервисы. Это обеспечивает высокий уровень безопасности данных и полное соответствие требованиям по защите персональных данных и коммерческой тайны.