
На склад приезжает последняя фура за неделю, четыре поставщика в одной машине, сотни товарных позиций. Экспедитор передает стопку документов: УПД, ТТН, ТрН и другие документы с таблицами и печатями. Кладовщик поочередно сканирует их и отправляет сканы в офис – в очередь на ручную перепечатку сотрудниками ОЦО. Во время обработки всплывает ошибка: расхождения в силу повреждения товара, естественной убыли и других причин.
Дальше – часы поиска, звонки на склад, исправления задним числом в учетной системе. Или еще хуже: брак не зафиксирован, недостача не оформлена, учет не сошелся, а претензию поставщику предъявить уже невозможно, так как прошли сроки – для некоторых категорий товаров они очень короткие. В итоге компания просто теряет деньги. Если вы узнали себя – этот текст для вас. Рассказываем, как периферийное распознавание документов помогает избежать подобных проблем.
Где на самом деле теряются время и деньги
Зона приемки товаров – одно из самых перегруженных мест на складе. Документы регулярно расходятся с фактическим грузом, кладовщик допускает ошибки из-за спешки, в центрах обработки документов (ОЦО) ввод данных затягивается на сутки, а выявленное несоответствие даже в одной ячейке счета, УПД или накладной требует длительной сверки, поиска и корректировки сведений в учетной системе.
Главная проблема – ошибку могут обнаружить слишком поздно: в другом структурном подразделении, в другой день, когда товар давно лежит на полке или уже уехал к клиенту. В итоге компании тратят миллионы рублей ежемесячно – только на то, чтобы разобраться с такими инцидентами, провести повторную приемку или, если брак не был зафиксирован при поступлении товара, списать это как потери склада.
По отраслевой статистике, из-за недостаточного контроля приемки средние потери компаний в ритейле и e-commerce достигают 10-15% от стоимости партии. При объеме закупок 50 млн рублей в месяц это означает потери от 5 до 7,5 млн ежемесячно. Чтобы решить эту проблему, требуется усилить контроль и ускорить обмен данными – помочь в этом деле может автоматическое распознавание документов.
Какие документы проходят через склад
Склад невозможно представить без тысяч документов на бумаге и сканах. Все они – разных форматов, от разных поставщиков и в разном состоянии: от банальных ксерокопий с артефактами сканирования до сложенных, помятых или запачканных страниц. Рукописные пометки, зачеркивания или таблицы на сотни строк в документах тоже не редкость – но вся эта информация важна и должна быть оцифрована. Чем быстрее, тем лучше.
| Процесс | Типовые документы |
| Приемка товара | Товарная накладная (ТОРГ-12), УПД, счет-фактура, ТТН, акт о расхождениях |
| Отгрузка товара | Акты, заявки, накладные и УПД, ТТН, доверенности |
| Передача ценностей | Накладные МХ-18, М-11 |
| Инвентаризация | Сличительные ведомости ИНВ-1, ИНВ-19 и другие документы |
В ходе фактической приемки или передачи груза могут вскрыться недочеты по количеству или составу товара, повреждения при транспортировке, естественная убыль и другие обстоятельства. Чтобы избежать потерю времени и денег, бизнесу принципиально важно быстро синхронизировать эти сведения с цифровыми данными в WMS, CRM и других системах.
Закрыть этот разрыв помогает периферийное распознавание – технология мгновенного ввода документов с помощью смартфона, планшета и любого другого подручного устройства.
Распознавание «на месте»: зачем это нужно
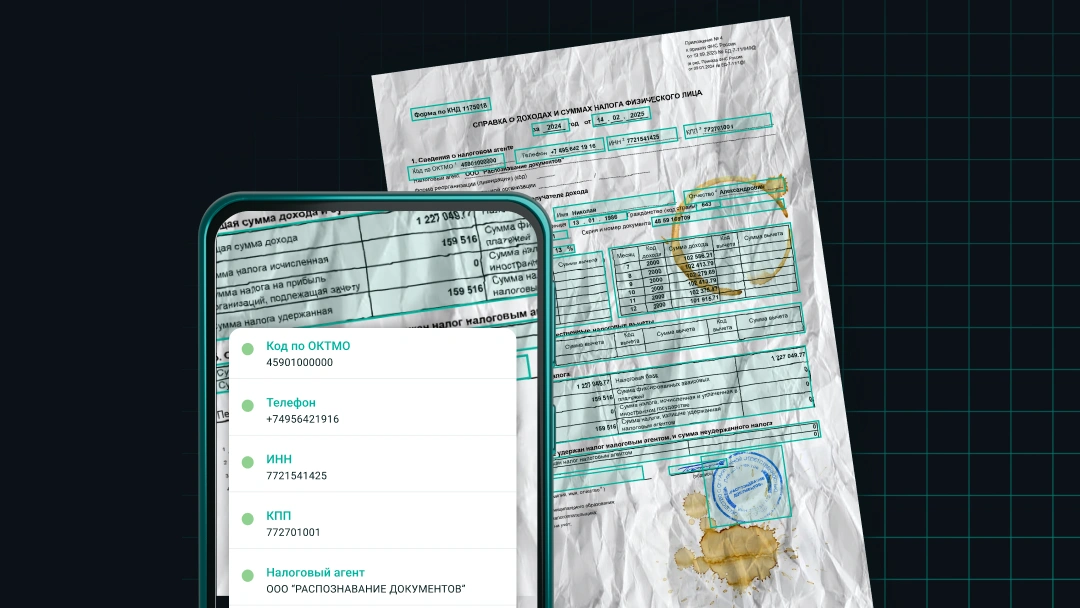
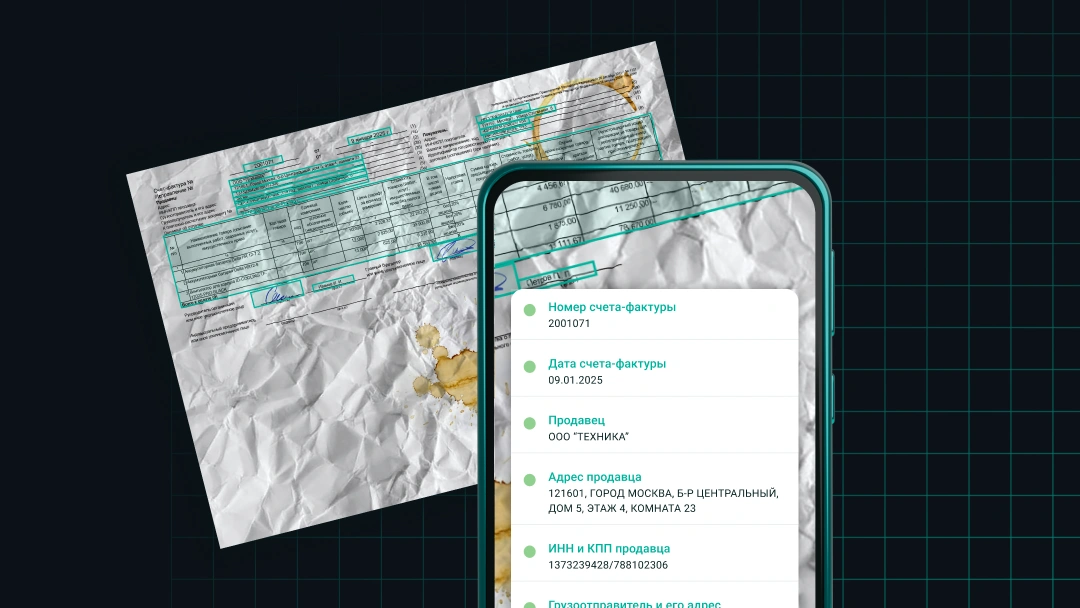
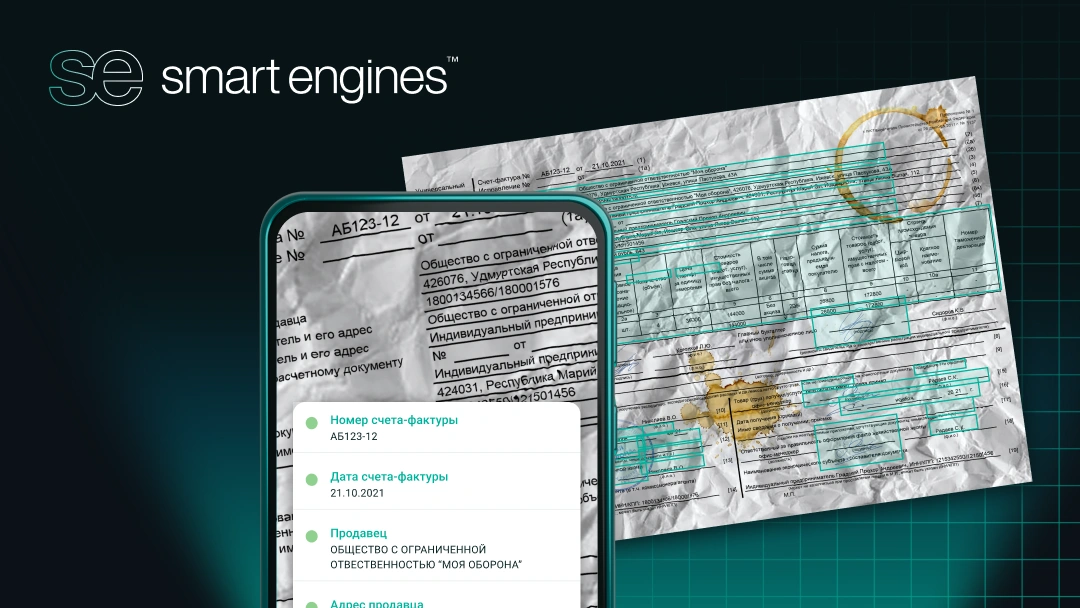
Главная идея периферийного распознавания на складе – в том, чтобы получать содержимое документа там и тогда, где он появился. Сегодня для этого достаточно навести камеру смартфона на накладную, акт, УПД или другую форму и сделать фото. Технология распознавания сама находит документ на изображении, определяет его тип, находит границы таблиц, распознает печатные и рукописные реквизиты, подписи и печати и за секунды возвращает структурированные данные.
Именно по такому принципу работает платформа периферийного распознавания документов Smart Document Engine. Решение не выдает набор разрозненных слов и чисел, а восстанавливает структуру документа, включая табличную зону, целиком: связывает каждое извлеченное значение с нужным полем. Наименование товарных позиций, количество, цена, сумма, ставка НДС моментально становятся доступны для интеграции в корпоративные системы и сверки с фактической поставкой и заказом.
По сравнению с обработкой в ОЦО и других аналогичных отделах – когда бумажный документ сканируется и отсылается в отдельное подразделение компании на ручной ввод – такой подход приносит сразу несколько практических преимуществ.
- Скорость. Моментальное извлечение позволяет извлекать данные, обнаруживать расхождения и вносить корректировки непосредственно в реальном времени. Это закрывает временной разрыв между фактической операцией и «опаздывающим» отражением данных в системе.
- Качество. Качество распознавания с помощью платформы Smart Engines позволяет перевести ввод данных из документов в полностью автоматический режим. Для бизнеса это означает снижение ошибок ручного ввода, рисков невнимательности и спешки кладовщика.
- Независимость. Платформа работает полностью локально, на любом устройстве, без передачи данных во внешние сервисы, требования интернет-подключения и GPU. Для склада это важно: зоны погрузки и удаленные площадки не всегда обеспечены стабильным интернетом, а сведения о поставках, ценах и контрагентах не покидают периметр компании.
- Экономия. Вместо траты финансовых и административных ресурсов на повторные операции, расследование инцидентов и закрытие периодов «задним числом», все ошибки и расхождения можно зафиксировать и исправить непосредственно в момент фактической операции.
В итоге вся система становится значительно более прозрачной и прослеживаемой – без операционных и временных разрывов. Руководство компании сразу видит актуальную картину бизнеса и может принимать решения на основе фактических данных.
Распознавание документов в реальных условиях
Склады, терминалы и логистические центры прямо препятствуют тому, чтобы документы хранились в идеальном состоянии. Поэтому обязательным требованием к технологии распознавания является способность работы в условиях реальной эксплуатации: с изображениями низкого качества, помятыми и сложенными документами, в плохом освещении.
В Smart Document Engine все это учтено: технология с высокой точностью извлекает печатные и рукописные данные, даже если документ в кадре повернут, многократно сложен, смят или был сфотографирован под углом и в темноте. Для документов, где ошибка в цифре превращается в реальные деньги, это принципиально важная функциональность.
В итоге, благодаря периферийному распознаванию документов, меняется сам процесс. Документ превращается в данные прямо на месте, а сотрудник склада может принимать решение, фиксировать расхождения, пересчитывать и вносить поправку, пока товар перед глазами – без необходимости дожидаться, пока документы пройдут через руки оператора. Так зона приемки товара на складе становится точкой ввода данных, а ОЦО получает возможность перейти от роли центра ручного ввода к функции центра экспертизы и контроля.