Универсальный передаточный документ объединяет функции первичного учетного документа и счета-фактуры. Формально – меньше бумаг. Но не меньше данных: в одном УПД могут находиться реквизиты контрагентов, номенклатура, цены, объемы поставки, ставки НДС и десятки или сотни товарных позиций. В разных сценариях, например при приемке товара на складе или сверке с фактически оказанными услугами наименования, суммы, количество и другие данные из УПД требуется быстро интегрировать в корпоративную систему.
Для этого УПД сначала сканируют, затем отправляют в ОЦО, где первичные бухгалтерские документы встают в очередь на обработку. Далее данные из документа вручную переносятся в систему учета, выявленные расхождения возвращают на корректировку, а исправленный документ снова проходит тот же маршрут. Пока этот цикл повторяется, бизнес не может оперировать актуальными данными, а склад, финансовая служба и отдел закупок ждут, когда данные появятся в 1С или ERP.
Периферийное распознавание позволяет перенести обработку документа непосредственно туда, где происходит хозяйственная операция, и сократить разрыв между фактической поставкой и появлением данных в корпоративной системе. При такой модели ОЦО перестает быть точкой ручного ввода каждого документа и может сосредоточиться на контроле, сложных случаях и экспертных задачах.
Сегодня расскажем, как автоматизировать распознавание УПД, сократить объем ручных операций и сохранить коммерчески значимые сведения в защищенном контуре организации.
Почему централизованная обработка УПД мешает управлять бизнесом в реальном времени
При централизованной обработке между хозяйственной операцией и ее отражением в учете возникает временной разрыв. Товар уже прибыл на склад или услуга фактически оказана, но корпоративная система еще не получила подтверждающие сведения из УПД.
Пока документ проходит очередь, ручной ввод и проверку, руководство и профильные подразделения работают с неполной или устаревшей картиной. Такая модель создает для бизнеса сразу несколько проблем:
- Нет прозрачности. Сведения о хозяйственных операциях появляются в системе только после обработки документов в ОЦО. До этого невозможно получить объективную картину по поставкам, приемке и расчетам.
- Нет полной прослеживаемости. Чем больше этапов проходит документ, тем сложнее быстро сопоставить данные в системе с исходным УПД, найти причину расхождения и определить, на каком этапе возникла ошибка.
- Не хватает оперативности. Запаздывающие данные замедляют контроль поставок, остатков, платежей и себестоимости, а также усложняют закрытие отчетного периода.
Дополнительной трудностью становится ручной ввод. Табличная часть УПД может содержать десятки или сотни строк, каждую из которых необходимо перенести и проверить. Неверный ИНН создает проблему в карточке контрагента, пропущенная позиция приводит к расхождению между поставкой и данными ERP, а неправильная сумма или ставка НДС влияет на расчеты и учет. При обнаружении ошибки документ возвращается на корректировку и снова проходит через ОЦО.
Масштабировать процесс за счет новых операторов невыгодно. Вместе с фондом оплаты труда растут расходы на подбор, обучение и контроль, но зависимость от человеческой внимательности сохраняется. В периоды пиковых нагрузок документы накапливаются, сроки проведения операций увеличиваются, а сотрудники вместо содержательной проверки занимаются перепечаткой. При этом, когда пик пройден, расширенный штат операторов становится нецелесообразным.
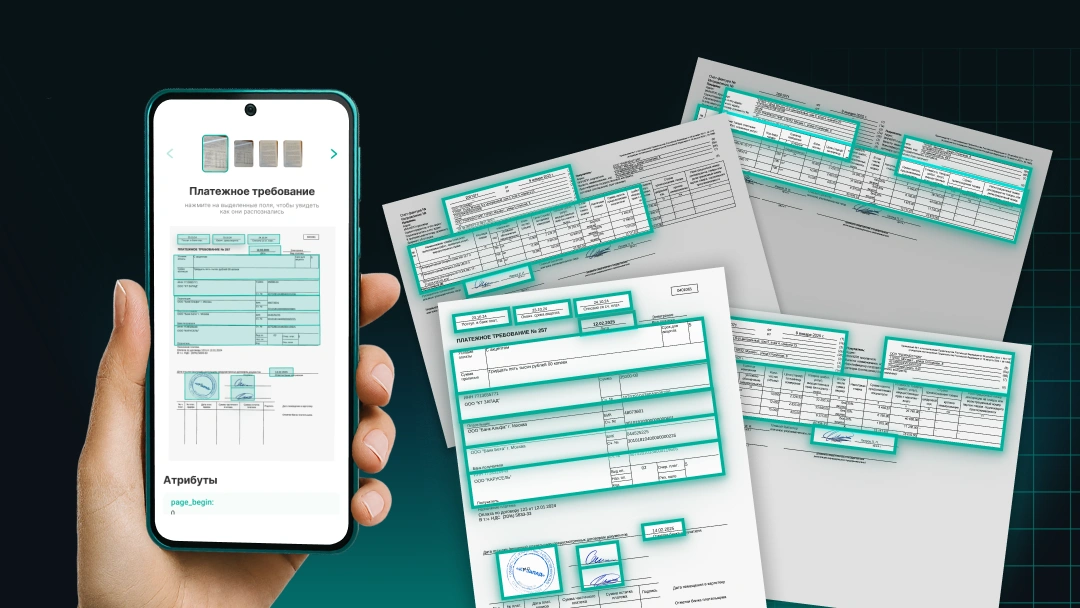
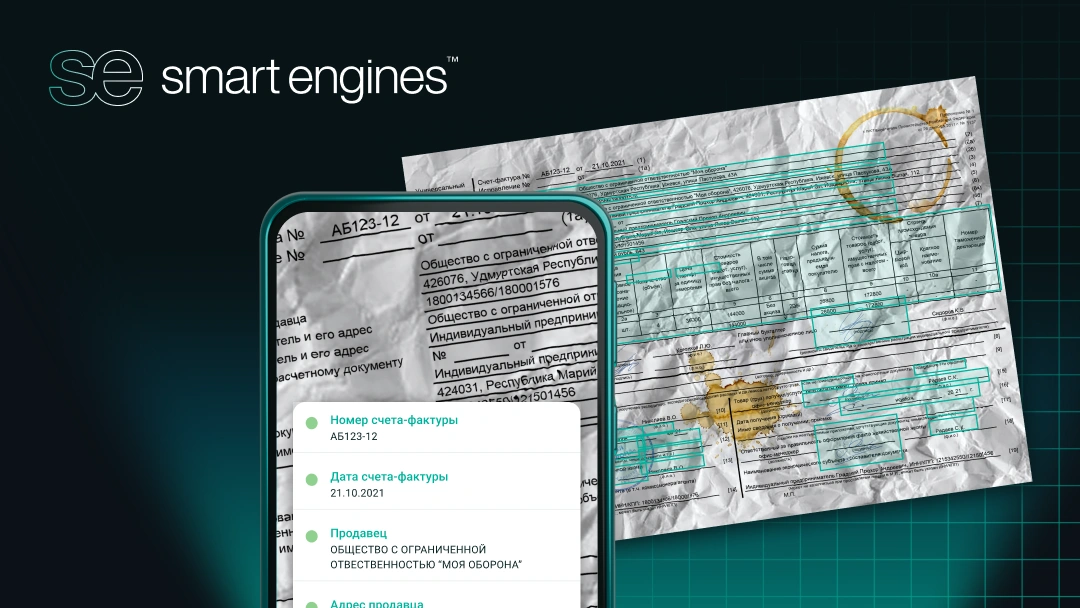
Периферийное распознавание меняет саму логику процесса. УПД обрабатывается там и тогда, где происходит хозяйственная операция. Сотруднику достаточно отсканировать документ или сфотографировать его на месте с помощью смартфона или планшета. Решение Smart Document Engine автоматически определяет его тип, извлекает реквизиты и табличные данные, проверяет наличие подписей и печатей и передает готовый результат в ERP, WMS или другую корпоративную систему.
В результате данные об операции появляются в системе без ожидания первичной обработки в ОЦО. Каждую операцию можно сопоставить с исходным документом, а результат распознавания – проверить вплоть до отдельного символа.
ОЦО подключается только к сложным и спорным случаям, а собственник получает актуальную картину бизнеса и принимает решения на основе фактических данных.
Почему облачный OCR не возвращает бизнесу полный контроль
Автоматическое распознавание устраняет значительную часть ручного ввода в ОЦО и при вводе документов на месте, однако при выборе OCR-системы важно оценивать не только точность. Не менее существенный вопрос заключается в том, где обрабатывается УПД.
При использовании облачного сервиса документ необходимо передать в стороннюю инфраструктуру. Изображение передается на серверы провайдера, в некоторых сервисах для ввода данных привлекаются верификаторы. В цепочке появляются дополнительные участники и технические компоненты, условия работы которых заказчик не контролирует напрямую.
Облачная обработка также создает зависимость от интернет-соединения, доступности API, текущей нагрузки на сервис и установленных провайдером правил хранения файлов. Если сторонний сервис недоступен, распознавание останавливается вместе с завязанным на него бизнес-процессом.
При локальной обработке УПД распознается непосредственно на устройстве сотрудника. Компания самостоятельно контролирует инфраструктуру, права доступа и дальнейший маршрут документа. Такая архитектура дополняет периферийную модель: УПД можно обработать как в ОЦО, так и непосредственно в точке приемки или отгрузки, сразу передать результат в корпоративную систему и при этом не зависеть от доступности стороннего OCR-сервиса.
Как распознать УПД с помощью Smart Document Engine
Smart Document Engine распознает УПД на фотографиях, сканах и в многостраничных файлах. Обработку можно запустить на сервере внутри инфраструктуры заказчика, на компьютере, смартфоне, планшете или непосредственно в браузере.
Система находит документ на изображении, определяет его границы и исправляет геометрические искажения. Затем она классифицирует документ как УПД, распознает основные реквизиты и восстанавливает структуру табличной части. На выходе формируется набор структурированных данных, который можно передать в 1С, ERP, СЭД или другую корпоративную систему.
Сотрудник при этом не исключается из процесса полностью. Его роль меняется: вместо построчной перепечатки человек проверяет поля с низкой уверенностью распознавания и принимает решения по спорным документам. Такой подход позволяет оставить специалисту содержательный контроль и снять с него механическую работу.
Возможности Smart Document Engine для обработки УПД
Платформа распознавания первичных документов поддерживает следующие возможности:
- автоматически определяет УПД в смешанном потоке первичных документов и обрабатывает связанные страницы как единый комплект;
- извлекает номер, дату и статус документа, реквизиты продавца и покупателя, ИНН и КПП, сведения об основании передачи, товарные позиции, количество, цены, суммы и ставки НДС;
- распознает сложные таблицы, печатные и рукописные реквизиты, отметки, штрихкоды, тексты печатей и штампов;
- работает со сканами, фотографиями и изображениями низкого качества, включая документы с поворотами, тенями, бликами, изгибами и геометрическими искажениями;
- поддерживает документы с различным оформлением без жесткой привязки к одному шаблону;
- возвращает координаты найденных объектов и показатели уверенности, чтобы корпоративная система могла направлять на проверку только сомнительные поля;
- выполняет обработку на устройстве или внутри инфраструктуры заказчика без передачи изображений в облако, сторонним сервисам и верификаторам;
- встраивается в мобильные, веб-, десктопные и серверные решения и передает структурированный результат в 1С, ERP, СЭД и другие информационные системы.
Что получает бизнес
Распознавание УПД сокращает интервал между фактической поставкой и появлением корректных данных в учетной системе. Склад быстрее подтверждает приемку, бухгалтерия своевременно получает первичные документы, финансовая служба не задерживает оплату из-за очереди на ввод, а закупки видят актуальную информацию по номенклатуре и стоимости.
При периферийной модели данные поступают в учетную систему непосредственно с места операции, а в ОЦО передаются уже те случаи, где действительно требуется профессиональная проверка или решение специалиста.
Smart Document Engine закрывает обе ключевые задачи работы с УПД: извлекает бизнес-значимые данные непосредственно в месте проведения операции и обрабатывает их локально. В результате компания ускоряет учетные процессы, сокращает стоимость обработки первички и получает актуальную картину бизнеса без очередей на ручной ввод.
Если хотите протестировать функциональность решения для автоматического распознавания УПД и других бухгалтерских документов, пишите Smart Engines!