Товар принят, но данные в систему не попали, потому что на складе «отвалилась» связь или облачный сервис обработки документов дал сбой? Готовьте кошелек.
Если распознавание документов зависит от облака, любая проблема на стороне внешней инфраструктуры или недоступность сервиса грозить оставить ключевые хозяйственные операции без учета. Фиксировать поставки и делать проводки в системе придется с опозданием, а расхождения и неучтенный товар будут списаны как потери склада – так «складываются» миллионные расходы бизнеса. Ежемесячно.
Избежать этого позволяет периферийное распознавание: ввод данных из документов прямо в точке фактической операции, без отправки изображений во внешние сервисы – прямо на складе или производстве. Рассказываем, какие преимущества дает локальная обработка документов и как периферийное распознавание обеспечивает непрерывность и отказоустойчивость бизнес-процессов.
Какие процессы страдают при сбое облачного сервиса
Когда данные из документов обрабатываются на внешнем облачном сервисе, бизнес сознательно идет на риски внезапных сбоев. Можно верить заверениям провайдеров и надеяться, что сервис никогда не перестанет работать. Но прагматичный подход звучит иначе: где тонко, там и рвется. Любая внешняя сторона, которой вы доверяете чувствительные процессы в компании, как раз и является таким тонким местом.
Если распознавание документов внепланово останавливается, сбой распространяется дальше:
- Ввод данных из первички. Акты, счета-фактуры, УПД, товарные и транспортные накладные, формы ТОРГ-12 не попадают в систему в момент приемки или отгрузки.
- Бухгалтерский учет. Складские остатки и бухгалтерские данные устаревают: товар физически есть, а в системе его нет. Для отдельных категорий товаров с ограниченным сроком годности это может обернуться потерей целой партии.
- Сверка позиций. Сотрудники не могут в реальном времени сопоставить фактически принятое количество с документами поставщика, чтобы зафиксировать различия.
- Фиксация расхождений. Недостачи, повреждения и пересортица обнаруживаются позже, когда доказать их причину уже трудно, и превращаются в потери склада.
Все вместе, сбои в этих процессах приводят к главному последствию – прямым финансовым потерям, которые могут достигать десятков миллионов рублей. По отраслевой статистике, в среднем потери компаний достигают 10-15% от стоимости партии – и это только на этапе приемки. Хотя виновник – явно другой.
Главная проблема заключается в том, что такие потери редко считаются в совокупности – пока внезапный сбой облачного сервиса не парализует сразу все ключевые процессы в компании.
Что дает бизнесу периферийное распознавание документов
Периферийное распознавание обеспечивает автоматическое извлечение данных непосредственно там, где появляется документ и принимаются решения. Распознавание первички выполняется на смартфоне или планшете сотрудника склада, на компьютере в бухгалтерии, на локальном сервере внутри инфраструктуры компании. В такой модели документ никогда не покидает контур организации для обработки, а данные извлекаются сразу, в момент операции.
Главная ценность такого подхода – полная инфраструктурная независимость. Компания не зависит от стабильности интернет-соединения, доступности внешнего API и условий обработки информации третьей стороной. А значит, работа с документами не останавливается из-за обстоятельств, на которые бизнес повлиять не может.
Это сразу дает ряд преимуществ:
- Независимость от внешней инфраструктуры. Распознавание работает на устройстве сотрудника или внутри контура компании, поэтому не зависит ни от интернета, ни от доступности облачных сервисов.
- Непрерывность процессов. Ввод данных, учет, сверка позиций и фиксация расхождений идут без пауз, даже если связь пропала или внешний сервис дал сбой.
- Отказоустойчивость. Чужой сервис перестает быть точкой риска остановки ключевых процессов в компании.
- Актуальные данные. Сведения о поставке попадают в учетную систему в момент приемки, а не спустя часы или дни, и расхождения видны сразу.
- Защита информации. Документы с коммерческой тайной и персональными данными остаются внутри организации и не могут утечь по вине внешнего подрядчика.
Таким образом, периферийное распознавание обеспечивает полную непрерывность и отказоустойчивость бизнес-процессов – никаких «извините, сервис недоступен по техническим причинам». Оно ускоряет ввод данных и повышает прозрачность ежедневных операций: содержимое документов моментально переносится в системы компании, а руководство может принимать решения на основе актуальной картины.
Облачное и периферийное распознавание: в чем разница
Основные различия представлены в таблице:
| Критерий | Облачный OCR | Периферийное распознавание |
| Независимость от интернета | ⚠️ Не работает без постоянного и стабильного подключения | ✅ Локальная работа без интернета на устройстве сотрудника |
| Непрерывность процессов | ⚠️ Сбой облачного сервиса останавливает ввод данных и связанные бизнес-процессы | ✅ Ввод, учет и сверка не зависят от сторонних вендоров и инфраструктуры |
| Фиксация расхождений | ⚠️ Данные появляются в системе с задержкой, расхождения выявляются позже | ✅ Данные извлекаются, а расхождения фиксируются прямо в момент приемки |
| Конфиденциальность | ⚠️ Риски утечки данных, потому что документы с коммерческой тайной и персональными данными отправляются в инфраструктуру стороннего провайдера | ✅ Документы и распознанные данные остаются внутри компании |
Платформа периферийного распознавания Smart Engines
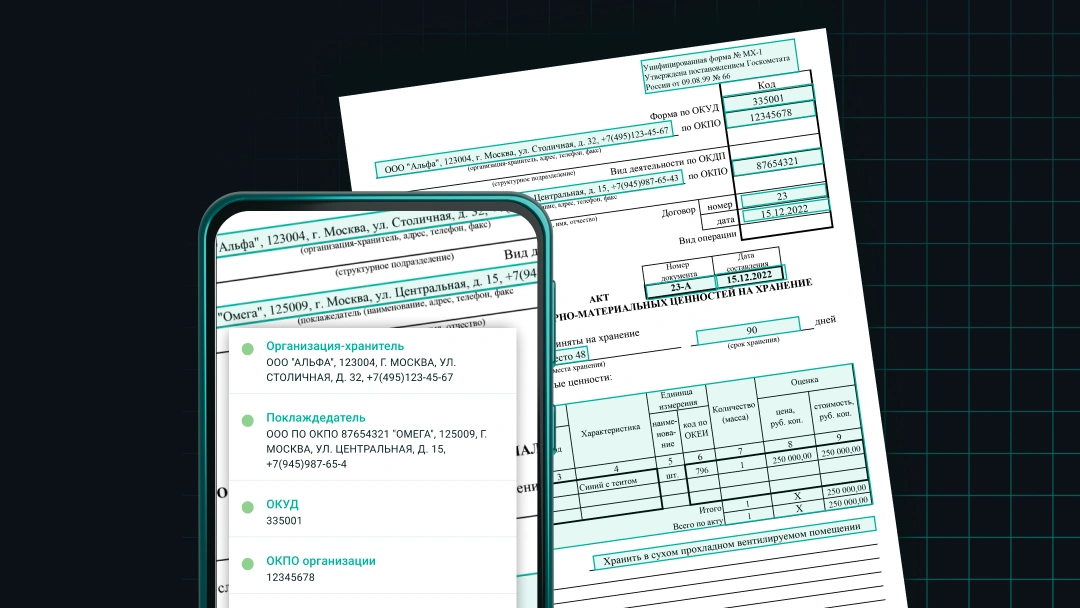
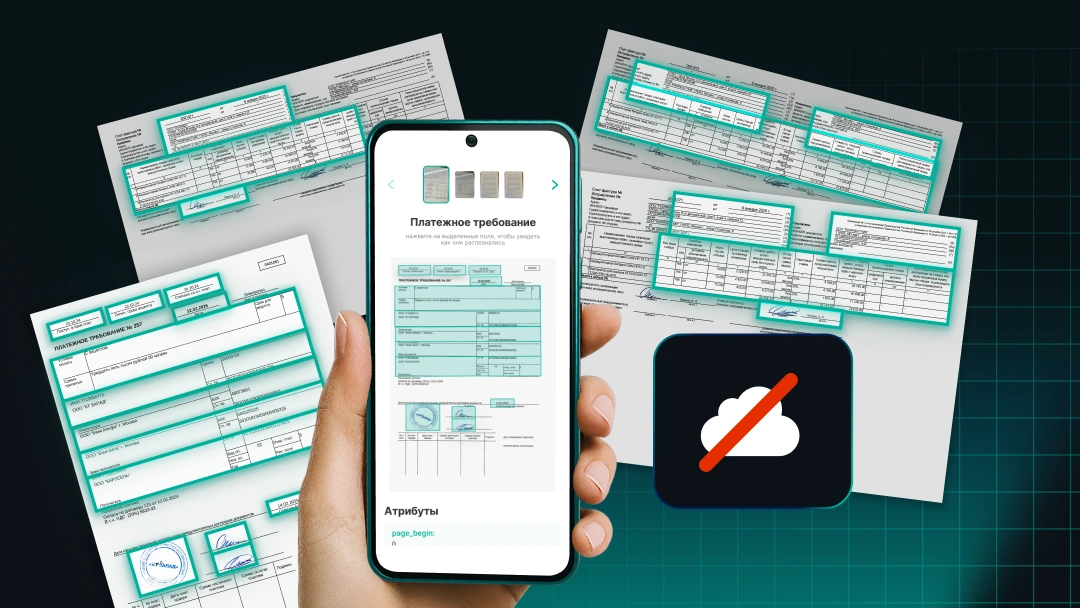
Платформа Smart Document Engine позволяет распознавать акты, счета-фактуры, УПД, ТОРГ-12 и другие товарные и транспортные документы прямо на месте фактической операции: на смартфоне, планшете или компьютере сотрудника. Решение работает в мобильных приложениях и браузере, а также на сервере внутри инфраструктуры заказчика. Извлечение данных выполняется 100% локально, без передачи изображений и распознанных реквизитов внешним OCR-провайдерам.
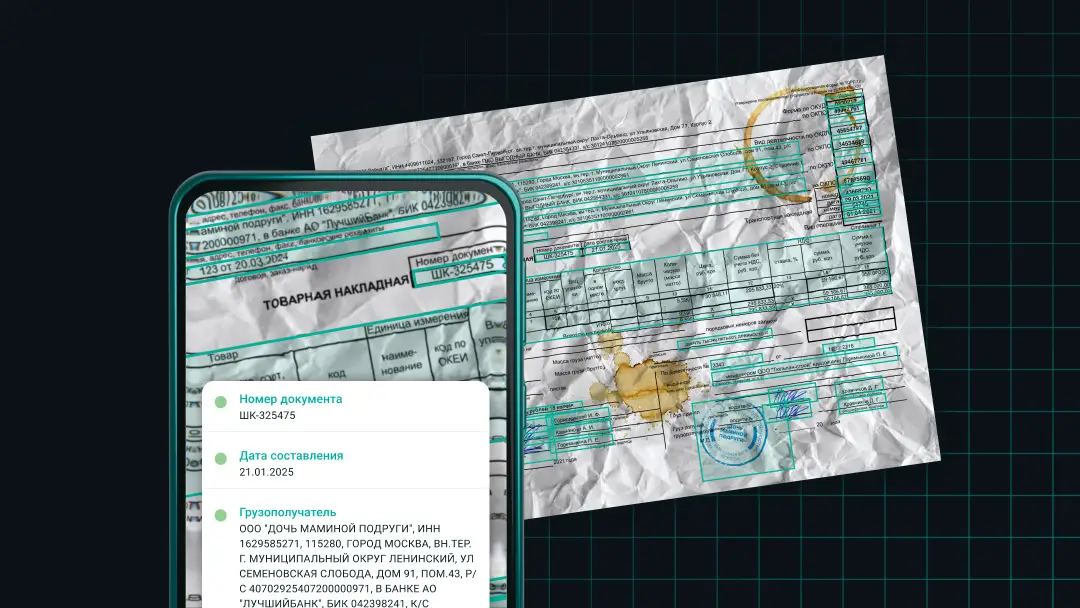
Сотруднику достаточно сфотографировать документ или загрузить скан. Платформа сама определяет тип документа, извлекает реквизиты, таблицы, проверяет наличие подписи и печати и передает готовые структурированные данные в учетную систему. Специально настраивать освещение или искать подходящее помещение не нужно: технология уже адаптирована к недостаточному и неравномерному освещению, съемке под углом и на весу, а также бликам, сгибам и другим помехам.
Smart Document Engine:
- классифицирует документы даже в смешанном потоке первички;
- распознает сложные таблицы и сохраняет связь между наименованиями, количеством, ценами и суммами;
- обрабатывает многостраничные документы как единое целое;
- извлекает печатный и рукопечатный текст, пометки, подписи и печати;
- возвращает показатели уверенности по каждому извлеченному символу.
Всего Smart Document Engine распознает 230 типов документов и поддерживает более 100 языков. На сервере платформа обрабатывает до 600 тысяч страниц в сутки – без использования GPU.
Все вместе, это дает не только технологическое преимущество в виде мгновенного извлечения данных, без отправки в облако и общие отделы. Но и полную независимость от любой внешней инфраструктуры и облачных сервисов – то есть уверенность, что вашему бизнесу не грозит остановка из-за случайной ошибки 503.