
В реальном бизнесе фактическая операция и ее отражение в учетной системе редко происходят одновременно. Груз уже поступил на склад, услуга оказана или товар доставлен заказчику, а информация об этом еще только начинает свой путь. Документы нужно собрать, передать на обработку, дождаться очереди, затем проверить и только потом – внести в систему. В результате между тем, что происходит в реальности, и тем, что видит бизнес в своих информационных системах, возникает разрыв. Это может привести к расхождению между хозяйственными операциями, принятию неверных управленческих решений, финансовым потерям, штрафам и проблемам с налоговой, а в отдельных случаях – и к уголовной ответственности.
Решить эту проблему помогает периферийное распознавание: документы обрабатываются и проверяются непосредственно в точке появления. В статье разберем, как периферийное распознавание меняет сам подход к обработке документов и позволяет бизнесу работать с данными практически в момент возникновения события.
Где возникают разрывы в бизнес-процессах
Во многих крупных компаниях документы из разных подразделений и филиалов поступают на обработку в общий центр обслуживания (ОЦО). Туда передают документы со складов, производственных площадок и других подразделений. Операторы проверяют их, извлекают необходимые данные и вносят информацию в корпоративные системы.
Такая схема позволяет стандартизировать обработку и сосредоточить экспертизу в одном центре, но у нее есть обратная сторона: данные попадают в учет только после того, как документ дошел до ОЦО и прошел весь цикл обработки. Пока это происходит, между реальным событием и его отражением в корпоративных системах возникает сразу несколько типов разрывов:
- Временной разрыв. Товар уже приехал на склад, но в учетной системе его еще нет. Документу предстоит пройти путь от получения и сканирования до обработки, проверки и внесения данных. В результате реальное событие может отразиться в учете только через несколько часов или даже дней.
- Информационный разрыв. Пока накладная, акт или счет существуют только в виде бумажного документа или изображения, содержащиеся в них данные недоступны информационным системам. Система не «знает» номенклатуру, количество, суммы, номера партий и другие сведения, хотя физически документ уже находится у компании.
- Контрольный разрыв. Вместе с данными откладывается и их проверка. Ошибки в реквизитах, расхождения по количеству и стоимости, дубли документов или проблемы с НДС обнаруживаются не в момент возникновения, а позже – когда документ доходит до обработки. К этому моменту исправить проблему может быть уже сложнее.
- Финансовый разрыв. Поставка состоялась и обязательство перед контрагентом уже возникло, но финансовые и управленческие системы еще этого не видят. Расходы, кредиторская задолженность и изменение запасов отражаются с задержкой, поэтому текущая финансовая картина компании расходится с фактической.
- Операционный разрыв. Разные подразделения начинают работать с разной картиной происходящего. Склад уже принял товар, закупки знают о поставке, а бухгалтерия и финансы еще ждут документы. В результате сотрудникам приходится дополнительно сверяться друг с другом, уточнять статусы и вручную восстанавливать актуальную картину.
В итоге между реальным положением дел и данными, на которые опирается руководство, возникает временной лаг – и управленческие решения принимаются по уже устаревшей картине бизнеса.
Что такое периферийное распознавание и как приблизить ввод данных к бизнес-событию
Традиционная схема предполагает, что документ движется к месту обработки: его передают из подразделения в ОЦО, где данные извлекают, проверяют и только затем вносят в корпоративную систему. Периферийное распознавание меняет эту логику: обработка переносится туда, где документ появляется и где происходит само бизнес-событие. Такой подход позволяет свести управленческий разрыв к нулю.
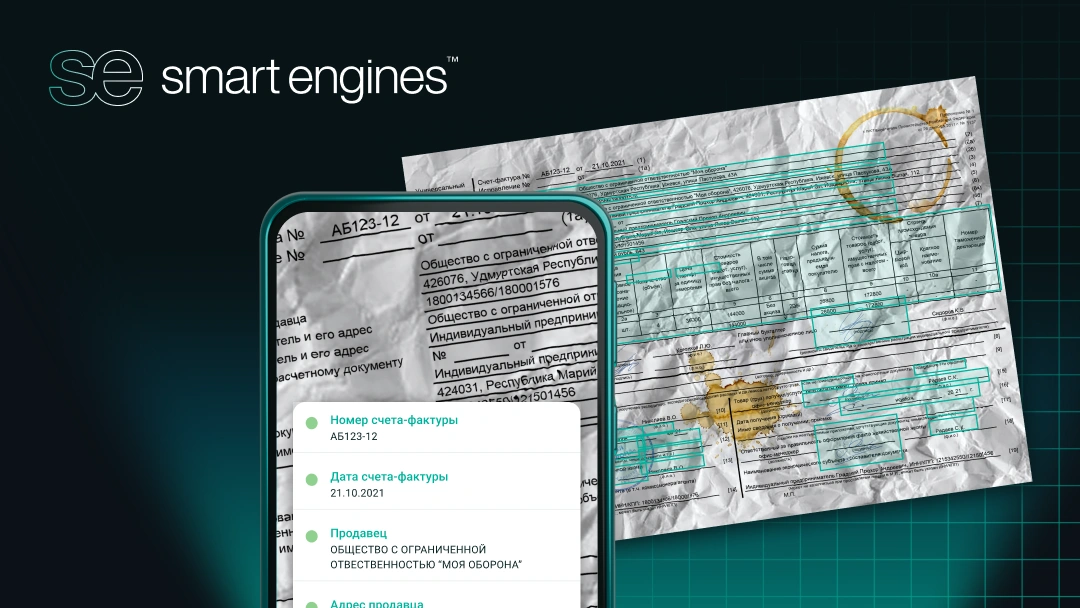
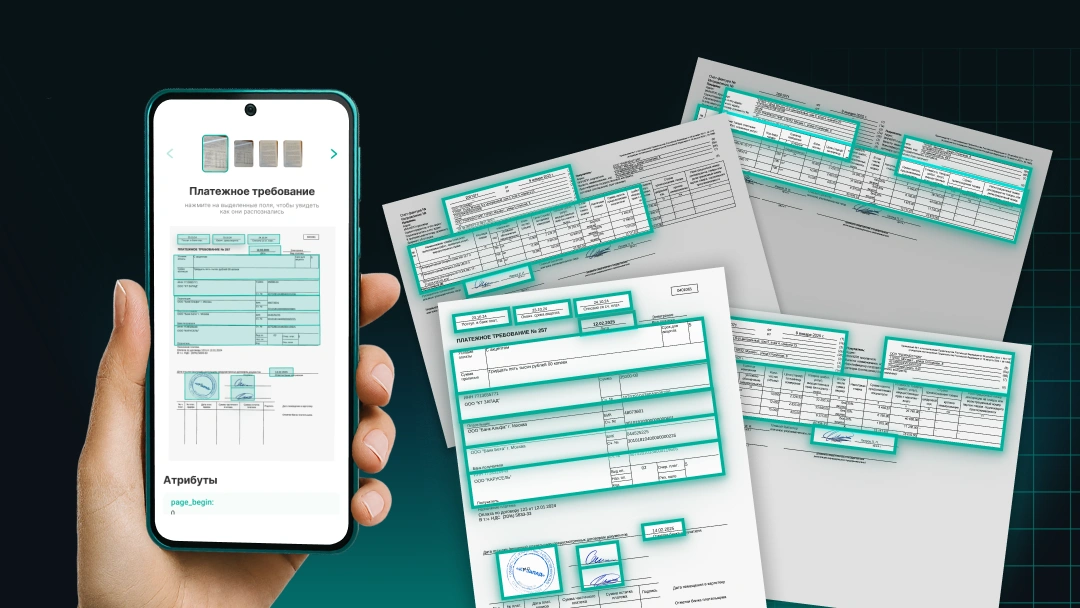
Кладовщик сканирует УПД, накладную, ТОРГ-12, акт, счет-фактуру или другой документ с помощью обычного смартфона. Система автоматически определяет его тип, извлекает реквизиты и табличные данные, проверяет наличие подписей и печатей и преобразует содержимое в структурированный вид.
После этого информация сразу становится доступна специалистам компании и корпоративным системам. Можно оперативно найти соответствующий заказ в ERP или WMS, сопоставить позиции документа с номенклатурой, проверить суммы, количество, адреса, НДС, ИНН и другие сведения, а также сразу выявить расхождения и проблемные места.
При этом периферийный ввод не ограничивается складом и первичной бухгалтерской документацией. По тому же принципу можно обрабатывать практически любые документы непосредственно в месте их появления: кадровые документы – при приеме сотрудника на работу, договоры и акты – при взаимодействии с заказчиком, транспортные документы – при отгрузке и доставке, уставы, приказы, выписки и другие документы юридических лиц – в корпоративных процессах. Для документов без заранее заданной структуры можно использовать полнотекстовое распознавание и сразу переводить их содержимое в цифровой вид. В каждом случае сохраняется один и тот же принцип: данные извлекаются там, где возникает документ, и сразу становятся доступны для дальнейшей обработки в информационных системах.
Перенести полный цикл распознавания документов из центра обработки непосредственно в точку их появления позволяет программный продукт Smart Document Engine.
Периферийный ввод на практике: возможности Smart Document Engine
Smart Document Engine от российской компании Smart Engines представляет собой высокопроизводительную on-premise IDP-платформу для интеллектуального ввода данных из структурированных, полуструктурированных и неструктурированных документов всех типов.
В основе решения лежит высокоточный OCR-движок компании для распознавания печатного и рукописного текста с точностью до 99,9%, а также сочетание авторских компактных алгоритмов для классификации, анализа и извлечения реквизитов из сфотографированных и отсканированных документов.
Решение обеспечивает:
- автоматическую классификацию документов на фото и сканах в едином потоке;
- распознавание структурированных и неструктурированных данных на 102 языках мира, включая английский, арабский, китайский, японский и другие;
- извлечение бизнес-значимых атрибутов и реквизитов с применением NLP;
- быстрое извлечение данных для наполнения корпоративных ИС;
- посимвольный контроль качества на всех этапах распознавания и обработки документов с привязкой к изображению документа на уровне знакомест отдельных символов, слов, строк и зон;
- построение прозрачных сценариев работы с документами на всех этапах.
Smart Document Engine встраивается в мобильные, десктопные и серверные приложения, поэтому устройством ввода может стать обычный смартфон или планшет сотрудника, рабочая станция, терминал или другое устройство, которое уже используется в бизнес-процессе. Документ не нужно сначала отправлять в ОЦО: его можно сфотографировать, распознать и проверить на месте, а в корпоративную систему передать уже готовые структурированные данные.
Система работает на любых процессорных архитектурах и операционных системах, в том числе на российских: Эльбрус, КОМДИВ-64, ARM, RISC-V, x86 и ОС Эльбрус, ОС Аврора, kvadraOS, Astra Linux, ALT Linux, РЕД ОС, РОСА «Хром», Windows, Linux и других. Суверенная технологическая база и сертифицированная совместимость с российскими платформами делают Smart Document Engine надежным решением для объектов КИИ, государственных компаний, компаний с госучастием и другого бизнеса.
Smart Document Engine входит в реестр отечественного ПО Минцифры РФ и относится к классу ИИ.
Сравнение: обработка в ОЦО vs Smart Document Engine
В таблице ниже показано, какой бизнес-эффект дает периферийное распознавание на месте с помощью Smart Document Engine.
| Параметр | Отправка в ОЦО | Периферийное распознавание с помощью Smart Document Engine | Что меняется для бизнеса |
| Временной разрыв между операцией и отражением данных | Составляет часы или дни – в зависимости от очереди в ОЦО | Отсутствует. Документы распознаются в момент операции, данные извлекаются мгновенно | Пропадает задержка между событием и его отражением в учете |
| Информационный разрыв | Данные остаются «запертыми» в бумажном документе или изображении до начала обработки | Реквизиты, таблицы и другие значимые данные сразу передаются в корпоративные системы | Моментальное отражение данных в ERP, WMS и других корпоративных ИС |
| Возможность сверки в реальном времени | Отсутствует. Ошибки, расхождения и проблемы с реквизитами обнаруживаются после передачи документа в ОЦО | Данные доступны для сверки с заказами, номенклатурой и другими сведениями непосредственно в момент обработки | Контроль в реальном времени, быстрее исправлять расхождения |
| Финансовый разрыв и подготовка отчетности | Поставка или обязательство уже существуют фактически, но еще не отражены в финансовых системах | Данные о суммах, НДС, количестве и других параметрах становятся доступны мгновенно | Быстрее закрываются периоды и готовится отчетность |
| Операционный разрыв | Склад, закупки, бухгалтерия и финансы могут работать с разными версиями текущей ситуации | Результат обработки становится доступен всем связанным системам и подразделениям | Снижается количество ручных сверок, запросов статуса и повторного ввода |
| Риски | Высокие из-за временных, операционных и других разрывов | Сведены к минимуму | Прозрачная работа с любыми документами на всех этапах |
Что получает бизнес
Периферийный ввод меняет не только скорость распознавания документов, но и саму логику работы с ними. Документ перестает быть физическим носителем, который сначала нужно доставить к месту обработки, и становится источником данных непосредственно в точке бизнес-события.
Со Smart Document Engine распознавание становится частью самого бизнес-процесса: документы обрабатываются там, где они появляются – на складе, производстве, рабочем месте сотрудника или мобильном устройстве. Камера смартфона или планшета становится точкой ввода, система определяет тип документа, извлекает реквизиты, таблицы и другие значимые данные, а корпоративные системы получают уже структурированный результат.
В результате данные о бизнес-событии появляются в информационной системе в момент, когда оно происходит, а не спустя часы или дни после обработки документов. Бизнес получает актуальную картину процессов, быстрее принимает решения и сокращает разрыв между реальными операциями и данными в корпоративных системах.