Корпоративные LLM все чаще используют для работы с договорами, перепиской, сканами и фотографиями документов. Однако прежде чем модель сможет проанализировать их содержимое, данные из документов необходимо оцифровать. Если для этого используется облачный OCR-сервис, конфиденциальные данные покидают защищенный контур компании еще до того, как попадут в LLM. В результате локальное развертывание модели просто теряет смысл, а весь процесс обработки документов оказывается зависимым от доступности внешнего облачного сервиса.
Разберемся, почему облачный OCR не подходит для обработки чувствительной информации, какие риски создает зависимость от внешних сервисов и как организовать распознавание документов внутри защищенного контура компании.
Почему локальной LLM недостаточно для защиты корпоративных данных
Сегодня компании все чаще заявляют, что используют для работы с корпоративными документами локальные LLM. Казалось бы, что еще нужно для безопасности? Модель развернута внутри защищенного контура, конфиденциальные данные не передаются третьим лицам, а коммерческая тайна остается под надежной защитой.
Однако безопасность всей системы определяется не только расположением LLM, но и архитектурой остальных компонентов. Для использования корпоративной LLM требуется «пища» – ей служат данные из оцифрованных документов. Прежде чем модель сможет проанализировать договор, скан или фотографию документа, его содержимое необходимо преобразовать в машиночитаемый текст с помощью технологии оптического распознавания символов (OCR). И здесь возникает не менее важный вопрос: где именно происходит распознавание – внутри защищенного контура компании или на серверах стороннего облачного провайдера?
Облачный OCR – слабое звено защищенной ИИ-инфраструктуры
Облачная модель распознавания предполагает передачу документов в сервис стороннего провайдера. При этом такая обработка далеко не всегда полностью автоматизирована: некоторые сервисы используют подход Human-in-the-Loop (HITL), при котором к вводу данных и ручному исправлению ошибок привлекаются операторы. Таким образом, конфиденциальная информация может оказаться доступна не просто внешней системе, но и анонимным третьим лицам.
Каждая передача документа за пределы корпоративного контура создает дополнительные риски информационной безопасности. Пропадает прозрачность бизнес-процессов, а сама компания оказывается лишенной контроля над тем, где обрабатываются документы, кто имеет к ним доступ, как долго они хранятся и удаляются ли после завершения распознавания.
Особенно критичны такие риски при обработке бухгалтерской, первичной, корпоративной, юридической и судебной документации. Эти документы могут содержать персональные данные, коммерческую тайну, сведения о финансовых операциях, условиях договоров, контрагентах и внутренних процессах компании. Их компрометация грозит не только репутационными потерями, но и финансовым ущербом, нарушением договорных обязательств, раскрытием коммерческой тайны и ответственностью за несоблюдение требований законодательства о защите информации. Например, в случае утечки персональных данных компания может быть подвергнута штрафам вплоть до 500 млн руб. в соответствии с 152-ФЗ.
Однако конфиденциальность – лишь одна сторона проблемы. Использование облачного OCR также делает корпоративную ИИ-инфраструктуру зависимой от доступности внешнего сервиса. Сбои на стороне провайдера, проблемы с интернет-соединением или недоступность внешнего API способны парализовать весь процесс обработки документов. Даже если локальная LLM продолжает исправно работать, она не сможет получить необходимые данные для анализа.
В результате облачный OCR становится одновременно потенциальной точкой утечки информации и несет риск сбоев в вашей системе, которая изначально создавалась как защищенная и автономная.
Как перенести распознавание документов внутрь корпоративного контура
Альтернатива облачному OCR – локальное распознавание документов по модели on-premise. В этом случае обработка данных происходит непосредственно в инфраструктуре компании, без обращения к сторонним сервисам. При этом для развертывания OCR необязательно выделять отдельный сервер: современные технологии позволяют выполнять распознавание на корпоративных компьютерах, планшетах и даже смартфонах.
В зависимости от задач и ИТ-инфраструктуры компания может выбрать один из двух подходов:
- Серверное (on-premise) распознавание. OCR-система разворачивается на собственных серверах компании или в изолированной частной инфраструктуре. Документы поступают на обработку по внутренним каналам, а результаты распознавания передаются корпоративным информационным системам и LLM. Такой подход подходит для централизованной обработки больших потоков документов, например в бухгалтерии, юридических подразделениях или общих центрах обслуживания. При этом дорогостоящие графические процессоры не нужны – современные OCR-движки работают на обычных центральных процессорах.
- Распознавание непосредственно на устройстве (on-device). OCR интегрируется в мобильное или веб-приложение, браузер или мессенджер – и выполняет распознавание на устройстве пользователя. Например, сотрудник может сфотографировать документ на смартфон и получить распознанные данные без отправки изображения на удаленный сервер. Это особенно удобно для выездных сотрудников, удаленного обслуживания клиентов и работы в условиях нестабильного интернет-соединения.
Преимущества on-premise и on-device распознавания документов
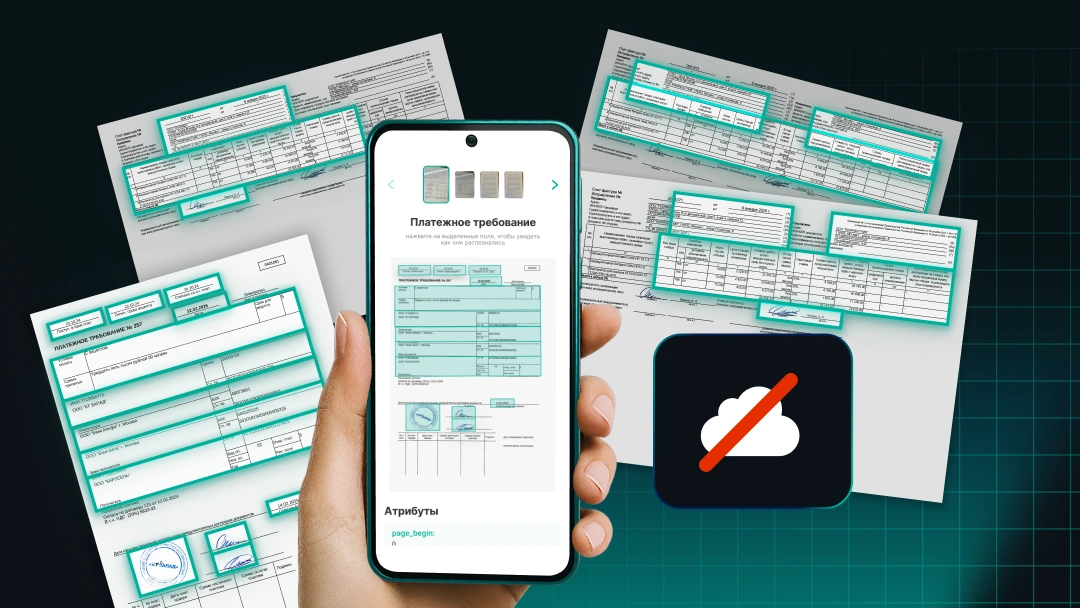
Главное преимущество обеих моделей – не только высочайшая скорость и отказоустойчивость распознавания, но и полный контроль над обработкой информации. Документы не требуется передавать облачному OCR-провайдеру, а компания самостоятельно определяет, где и как обрабатываются, хранятся и используются исходные изображения и результаты распознавания. Локальная технология OCR может работать даже без GPU и подключения к интернету, поэтому сбои внешних сервисов не влияют на доступность распознавания.
При этом переход на локальный OCR не требует отказа от существующей ИТ-инфраструктуры. Современные системы распознавания поставляются в виде программных компонентов – SDK, библиотек и API, которые можно встроить в корпоративные приложения, системы электронного документооборота и конвейеры обработки данных на базе LLM.
В результате компания получает возможность выстроить полностью локальную цепочку работы с документами: от загрузки скана или фотографии и извлечения текста до его анализа корпоративной языковой моделью. Все ключевые этапы обработки выполняются внутри контролируемой инфраструктуры, без зависимости от внешних OCR-сервисов.
От договоров до удостоверений личности: что должен уметь корпоративный OCR
Сегодня внутри защищенного корпоративного контура можно организовать распознавание практически любых документов, с которыми компания сталкивается в повседневной работе. Современные OCR-системы позволяют обрабатывать не только стандартные формы с фиксированным расположением полей, но и многостраничные документы произвольной структуры, сканы, фотографии и архивные материалы.
В зависимости от бизнес-задач локальное распознавание может охватывать следующие категории документов:
- Бухгалтерские и первичные учетные документы: счета, счета-фактуры, универсальные передаточные документы (УПД), товарные и транспортные накладные, акты выполненных работ, акты сверки, платежные поручения, бухгалтерские балансы и финансовая отчетность.
- Кадровые документы: паспорта РФ, СНГ и всех стран мира, трудовые книжки и СТД-Р, трудовые договоры, справки о доходах, документы об образовании, согласия на обработку персональных данных и другие материалы кадрового делопроизводства.
- Полнотекстовые документы: анкеты, опросники, заявления, согласия на обработку персональных данных, внутренняя переписка, служебные записки, инструкции, отчеты, документы по индивидуальным формам организации и многостраничные материалы со сложной структурой.
- Юридические документы: договоры и дополнительные соглашения, доверенности, претензии, исковые заявления, судебные решения, протоколы разногласий, исполнительные документы и другие материалы юридического сопровождения деятельности компании.
- Уставные и регистрационные документы: уставы организаций, учредительные договоры, выписки из ЕГРЮЛ и ЕГРИП, свидетельства ОГРН и ИНН, решения и протоколы собраний учредителей, приказы о назначении генерального директора.
- Документы, удостоверяющие личность: печатные и рукописные паспорта РФ, свидетельства ЗАГС, СНИЛС, ИНН, заграничные и иностранные паспорта, национальные ID-карты, водительские удостоверения, виды на жительство, визы и другие документы, используемые для идентификации клиентов, сотрудников и контрагентов.
И это далеко не полный перечень. Локальные OCR-системы также применяются для распознавания закупочной, логистической, технической, медицинской и другой специализированной документации. При необходимости технологии позволяют настраивать обработку собственных форм организации, извлекать отдельные реквизиты, таблицы и текстовые блоки.
Smart Engines: платформа локального распознавания документов
Реализовать полностью локальную обработку документов позволяет платформа распознавания Smart Engines. Решение объединяет технологии оптического распознавания символов на базе искусственного интеллекта и предназначено для автоматического ввода данных из широкого спектра документов – от бухгалтерской первички и многостраничных договоров до паспортов и других удостоверений личности.
Ключевые возможности Smart Document Engine для распознавания корпоративных документов:
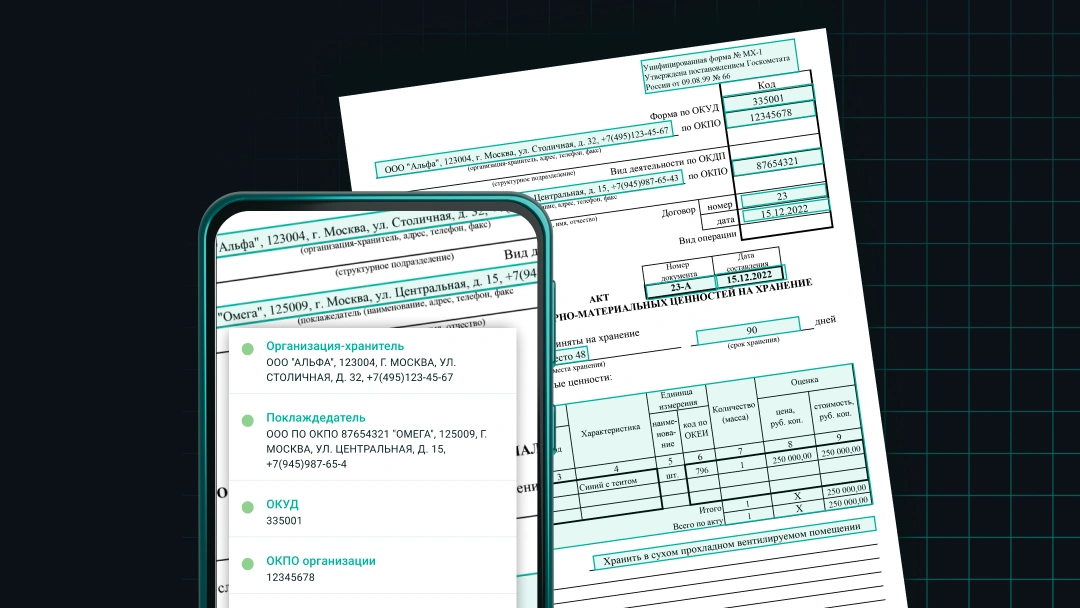
- Извлечение реквизитов и табличных данных. Распознавание данных контрагентов, номенклатурных позиций, количества, цен, итоговых сумм, НДС и других реквизитов.
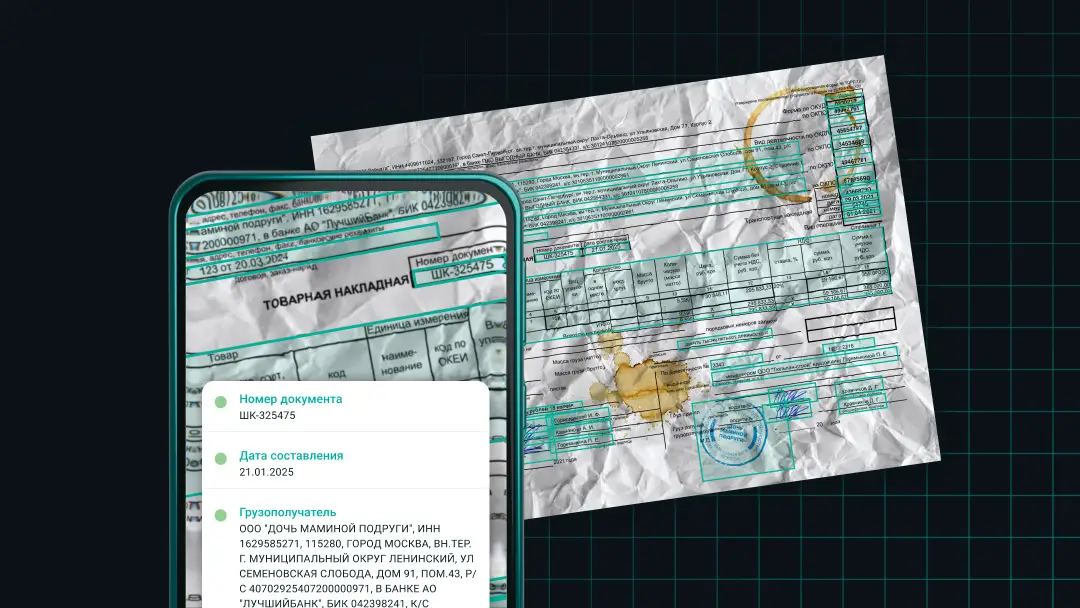
- Работа с изображениями разного качества. Обработка сканов и фотографий с перекосами, бликами, тенями, смазом и геометрическими искажениями.
- Поддержка многостраничных документов. Распознавание связанных страниц с сохранением структуры документа и таблиц.
- Распознавание печатного и рукописного текста. Извлечение текста, пометок, штрихкодов, определение наличия подписей и печатей.
- Автоматическая классификация. Определение типа документа во входящем потоке для последующей обработки по заданному сценарию.
- Высокая производительность. Потоковая обработка документов на центральных процессорах (CPU) без использования GPU.
- Интеграция с корпоративными системами. Передача распознанных данных в 1С, ERP, СЭД, корпоративные LLM и другие информационные системы через SDK и API.
- Дополнительные проверки документов. Контроль цветности и целостности, выявление признаков цифрового вмешательства, анализ подписей, печатей и штампов.
И все это – полностью локально. Smart Document Engine работает непосредственно в защищенном контуре компании (on-premise) или на устройстве пользователя (on-device). Для распознавания не требуется подключение к интернету: изображения документов и извлеченные данные не передаются во внешние облачные сервисы или сторонним операторам для ручной верификации. Вся обработка выполняется автоматически, внутри инфраструктуры заказчика. Это позволяет сохранить контроль над конфиденциальной информацией, исключить зависимость распознавания от доступности внешних OCR-сервисов и обеспечить автономную работу корпоративных ИИ-систем.
Если ваша LLM работает локально, убедитесь, что OCR тоже
Безопасность корпоративной ИИ-инфраструктуры зависит не только от расположения LLM, но и от всех этапов обработки документов. Облачный OCR создает риски утечки конфиденциальных данных и зависимость от сторонних сервисов.
Технологии Smart Engines позволяют распознавать корпоративные документы полностью локально – без передачи данных за пределы защищенного контура и без зависимости от внешних OCR-сервисов.
Развернули LLM внутри компании? Проверьте, не покидают ли ваши документы защищенный контур еще до того, как попадут в модель.